
Die Doktorandin Marta Arbizu Gómez analysiert die aktuelle wissenschaftliche Evidenz zu den Grenzen von Sprachmodellen beim klinischen Denken und deren Auswirkungen auf die tägliche klinische Praxis.
Eine in JAMA Network Open veröffentlichte Studie zeigt, dass Sprachmodelle (LLMs) bei der Differenzialdiagnose eine Fehlerquote von über 80 % aufweisen, trotz ihrer Genauigkeit bei der abschließenden Diagnose. In der neuropsychologischen Diagnostik und der neurologischen Rehabilitation belegen diese Daten, dass KI das menschliche klinische Denken nicht ersetzt und nur als ergänzendes Instrument unter fachlicher Aufsicht eingesetzt werden sollte.
Warum ist es wichtig, das klinische Denken künstlicher Intelligenz zu bewerten?
Große Sprachmodelle, bekannt als LLMs, gewinnen im Gesundheitswesen zunehmend an Bedeutung. Sie werden eingesetzt oder ihre Nutzung wird geprüft, um Krankenakten zusammenzufassen, Entscheidungen zu unterstützen, medizinische Fragen zu beantworten, Berichte zu erstellen oder bei der klinischen Dokumentation zu helfen.
Dennoch ist eine isolierte medizinische Frage korrekt zu beantworten etwas völlig anderes, als das vollständige klinische Denken nachzuvollziehen, das ein medizinischer Fachmann bei einem realen Patienten anwendet. In der klinischen Praxis ergibt sich eine Diagnose meist nicht aus einer einzigen Antwort, sondern aus einem schrittweisen Prozess: Informationen werden erhoben, Hypothesen aufgestellt, Untersuchungen angeordnet, Möglichkeiten ausgeschlossen und ein Behandlungsplan festgelegt.
Bisher basierten viele Bewertungen der künstlichen Intelligenz in der Medizin auf Multiple-Choice-Prüfungen, etwa medizinischen Zulassungsprüfungen oder Fragen mit vorgegebenen Antwortmöglichkeiten. Obwohl diese Formate nützlich sind, um Wissen zu messen, erfassen sie die Komplexität des klinischen Denkens nicht vollständig, insbesondere bei Unsicherheit.
Die in JAMA Network Open veröffentlichte Studie befasst sich genau mit dieser Frage: Können aktuelle LLMs über den gesamten klinischen Ablauf hinweg zuverlässig denken?
Melden Sie sich
für unseren
Newsletter an
Wie wurde die Untersuchung zu LLMs in der Medizin durchgeführt?
Die Autoren bewerteten die Leistung von 21 hochmodernen Sprachmodellen anhand von 29 standardisierten klinischen Fallvignetten aus dem MSD Manual. Diese Vignetten simulieren klinische Fälle Schritt für Schritt – von der Erstvorstellung des Patienten bis zur Diagnose und Behandlung.
Zu den untersuchten Modellen gehörten Systeme verschiedener Familien wie GPT, Claude, Gemini, DeepSeek und Grok. Darunter waren aktuelle und für das logische Denken optimierte Modelle wie GPT-5, Claude 4.5 Opus, Gemini 3.0 Pro und Grok 4.
Jedes Modell musste Fragen aus fünf Bereichen des klinischen Denkens beantworten:
- Differenzialdiagnose;
- diagnostische Untersuchungen;
- abschließende Diagnose;
- Behandlung oder Therapie;
- und zusätzliche klinische Fragen.
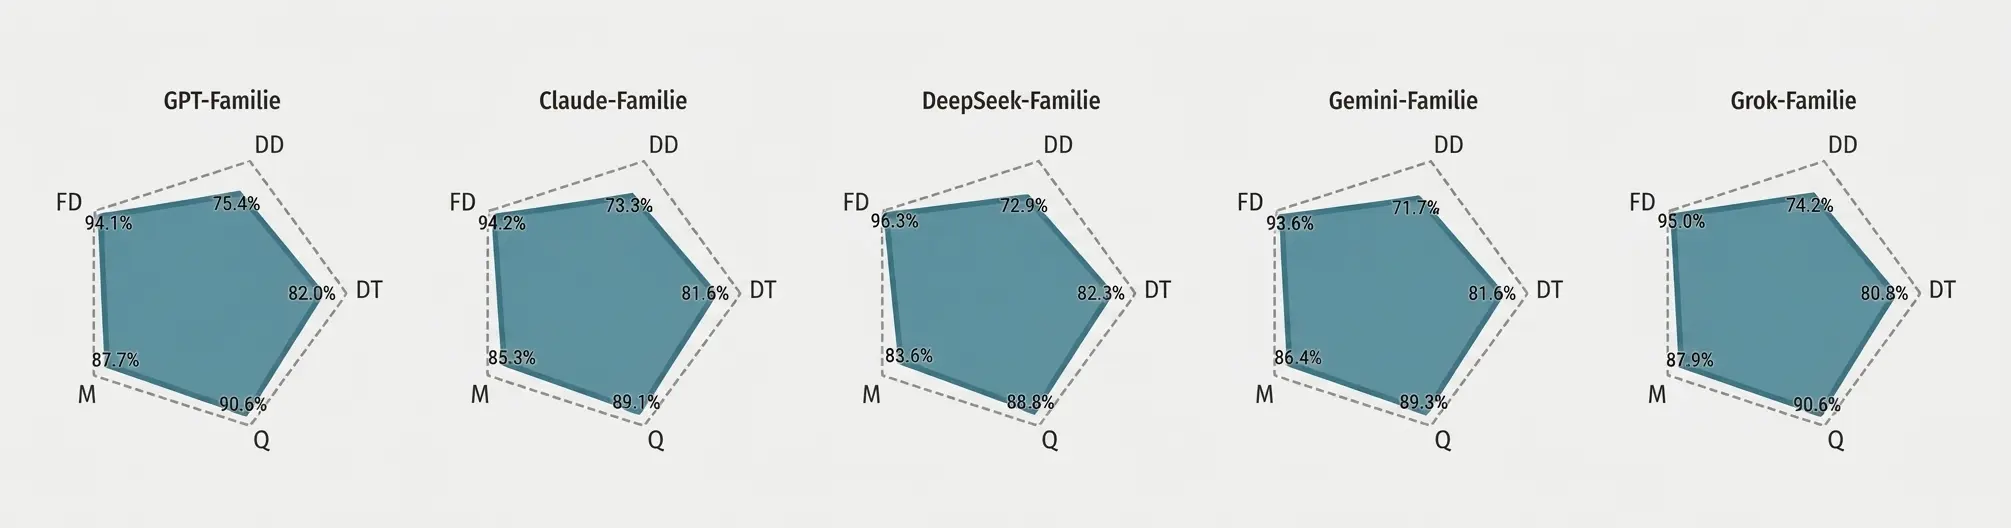
Zur Bewertung der Leistung beschränkten sich die Forschenden nicht auf die Berechnung der Gesamtgenauigkeit. Sie führten eine neue Metrik namens PrIME-LLM ein, die die ausgewogene Leistung des Modells in fünf Bereichen des klinischen Denkens zusammenfasst. Diese Metrik wird in Form von Radardiagrammen dargestellt: Je größer und ausgewogener die Fläche des Diagramms ist, desto besser ist die Leistung des Modells über den gesamten klinischen Prozess hinweg.
Was zeigen die wichtigsten Ergebnisse über LLMs bei Diagnosen?
Die Ergebnisse zeigen ein klares Muster: Aktuelle LLMs können gute Ergebnisse erzielen, wenn sie die abschließende Diagnose identifizieren sollen, haben jedoch deutlich größere Schwierigkeiten, wenn sie eine Differenzialdiagnose erstellen müssen.
Dieser Punkt ist besonders relevant, da die Differenzialdiagnose ein zentraler Bestandteil des medizinischen Denkens ist. Dabei werden verschiedene diagnostische Möglichkeiten berücksichtigt, Unsicherheiten aufrechterhalten und vorschnelle Festlegungen vermieden. Den Autoren zufolge neigen die Modelle dazu, vorschnell auf eine einzige Antwort zuzulaufen, statt flexibler zu denken, wie es ein Kliniker tun würde.
Modelle, die für logisches Denken optimiert waren, erzielten bessere Ergebnisse als nicht optimierte Modelle, doch diese Verbesserung beseitigte die wesentlichen Einschränkungen nicht. Selbst die fortschrittlichsten Modelle zeigten weiterhin deutliche Fehler in den frühen Phasen des klinischen Denkens.
Insgesamt erzielten Modelle wie Grok 4, GPT-5, GPT-4.5, Claude 4.5 Opus, Gemini 3.0 Flash und Gemini 3.0 Pro die besten Ergebnisse beim PrIME-LLM. Die Studie warnt jedoch davor, dass eine hohe Gesamtgenauigkeit wichtige Schwächen verdecken kann, wenn das Modell nicht bei allen Aufgaben ausgewogen leistungsfähig ist.
| Metrik oder Ergebnis | Wichtigste Erkenntnis |
|---|---|
| Untersuchte Modelle | 21 LLMs |
| Verwendete klinische Fälle | 29 Fallvignetten |
| Gesamtzahl analysierter Antworten | 16.254 |
| Beste Gesamtleistung | Aktuelle und für logisches Denken optimierte Modelle |
| Stärkster Bereich | Abschließende Diagnose |
| Schwächster Bereich | Differenzialdiagnose |
| Fehlerquote bei der Differenzialdiagnose | Bei allen Modellen über 0,80 |
| Nutzen von PrIME-LLM | Erkennt Ungleichgewichte, die die Gesamtgenauigkeit verdecken kann |
| Klinische Schlussfolgerung | LLMs sind ohne Aufsicht nicht für den autonomen Einsatz sicher |
Welche Auswirkungen hat dies auf die klinische Praxis?
Diese Studie enthält eine wichtige Warnung: Es reicht nicht aus, dass ein Modell abschließende Diagnosen korrekt stellt, um es in der Medizin als sicher einzustufen.
In der klinischen Praxis besteht eines der größten Risiken darin, dass ein Instrument eine scheinbar korrekte Antwort erzeugt, ohne andere Möglichkeiten angemessen berücksichtigt zu haben. Dies kann insbesondere in Situationen mit hoher Unsicherheit ein falsches Sicherheitsgefühl hervorrufen.
Die Ergebnisse deuten darauf hin, dass LLMs bei konkreten klinischen Aufgaben nützlich sein können, insbesondere wenn diese klar abgegrenzt sind und von Fachkräften überwacht werden. Sie könnten beispielsweise dabei helfen, Informationen zusammenzufassen, Daten zu strukturieren, die Überprüfung von Dokumenten zu unterstützen oder in Situationen mit geringer Unsicherheit als ergänzendes Instrument zu dienen.
Die Autoren sind jedoch eindeutig: Aktuelle Modelle sollten weder als autonome diagnostische Systeme noch in patientennahen Kontexten ohne klinische Aufsicht eingesetzt werden. Ihre Leistung bildet die Komplexität des menschlichen medizinischen Denkens noch nicht ab, insbesondere in den frühen Diagnosephasen.
Wie steht dieser Fortschritt im Zusammenhang mit NeuronUP?
Bei NeuronUP arbeiten wir mit evidenzbasierten digitalen Instrumenten für Rehabilitation und kognitive Stimulation. In diesem Zusammenhang sind Studien wie diese besonders relevant, weil sie dazu beitragen, die realistische Rolle künstlicher Intelligenz im Gesundheitswesen zu bestimmen.
KI kann einen Mehrwert schaffen, wenn sie verantwortungsvoll, transparent und unter Aufsicht integriert wird. So kann sie beispielsweise:
- die Organisation klinischer und funktioneller Informationen unterstützen.
- Eine strukturierte Verlaufskontrolle von Patienten erleichtern.
- zur Personalisierung kognitiver Interventionen anhand objektiver Daten beitragen.
- das Urteil von Fachkräften ergänzen, aber nicht ersetzen.
Dieser Artikel bekräftigt eine zentrale Idee: Gesundheitstechnologie muss nicht nur danach bewertet werden, ob sie korrekte Antworten liefert, sondern auch nach ihrer Sicherheit, Zuverlässigkeit und ihrem Nutzen innerhalb des gesamten klinischen Prozesses.
Im Bereich der neurologischen Rehabilitation bedeutet dies, Modelle zu entwickeln, bei denen künstliche Intelligenz die Entscheidungsfindung unterstützen kann, aber immer in professionelle Teams und klare klinische Kriterien eingebettet ist.
Testen Sie NeuronUP 7 Tage kostenlos
Probieren Sie unsere verschiedenen Übungen, erstellen Sie Sitzungen oder arbeiten Sie remote mithilfe von Online-Sitzungen
Fazit
Die Studie zeigt, dass Sprachmodelle erhebliche Fortschritte gemacht haben und bei bestimmten medizinischen Aufgaben gute Ergebnisse erzielen können. Dennoch weisen sie weiterhin wichtige Einschränkungen beim longitudinalen klinischen Denken auf, insbesondere bei der Erstellung von Differenzialdiagnosen und beim Umgang mit Unsicherheit.
Die neue Metrik PrIME-LLM ermöglicht eine umfassendere Bewertung dieser Modelle als die Gesamtgenauigkeit, da sie Ungleichgewichte zwischen den verschiedenen Phasen des klinischen Prozesses sichtbar macht.
Letztlich können LLMs vielversprechende Instrumente zur Unterstützung bestimmter Prozesse im Gesundheitswesen sein, sind jedoch noch nicht bereit, das menschliche klinische Denken zu ersetzen oder diagnostische Entscheidungen autonom zu treffen.
Literaturverzeichnis
- Rao AS, Esmail KP, Lee RS, Jiang S, Arraiza Carlo B, Gill J, Khanna P, Kalmowitz E, Montagnese B, Heydari K, Jiao Q, Bott E, Nguyen D, Wang G, Hood M, Landman AB, Succi MD. Large Language Model Performance and Clinical Reasoning Tasks. JAMA Network Open. 2026;9(4):e264003. doi:10.1001/jamanetworkopen.2026.4003.
Häufig gestellte Fragen zu LLMs in der Medizin
1. Können Sprachmodelle (LLMs) eigenständig klinische Diagnosen stellen?
Nein. Die untersuchten Modelle weisen bei der Erstellung von Differenzialdiagnosen eine Fehlerquote von über 80 % auf und neigen dazu, sich vorschnell auf eine einzige Möglichkeit festzulegen. Daher sind sie ohne die direkte Aufsicht einer medizinischen Fachkraft nicht für einen autonomen Einsatz geeignet.
2. Was ist die Metrik PrIME-LLM und warum ist sie wichtig?
Es handelt sich um eine Metrik zur Bewertung der ausgewogenen Leistung von Modellen in fünf Bereichen des klinischen Prozesses: Differenzialdiagnose, Untersuchungen, abschließende Diagnose, Behandlung und zusätzliche Fragen. Ihre Bedeutung liegt darin, dass sie Schwächen und Ungleichgewichte im Denken erkennt, die herkömmliche Metriken der Gesamtgenauigkeit häufig verbergen.
3. Wo liegen die wichtigsten Grenzen künstlicher Intelligenz im klinischen Ablauf?
Obwohl fortgeschrittene Modellfamilien wie GPT, Claude, Gemini, Grok oder DeepSeek die abschließende Diagnose gut identifizieren, zeigen sie in den frühen Phasen einen deutlichen Leistungsabfall. Ihre größte Einschränkung ist die Unfähigkeit, diagnostische Unsicherheit zu bewältigen und vor dem Abschluss eines Falls verschiedene Hypothesen abzuwägen.
4. Welche Bedeutung haben diese Ergebnisse für die kognitive Diagnostik und Rehabilitation?
Die Studie zeigt, dass KI das fachliche Urteil bei der neuropsychologischen Diagnostik nicht ersetzen darf. Die Technologie bleibt jedoch eine hervorragende ergänzende Ressource, um klinische Informationen zu organisieren, kognitive Interventionen zu personalisieren und die Patientendokumentation nach den Vorgaben der Fachkraft zu optimieren.

 Innovation in der Neurorehabilitation: Die Kombination von Präsenz- und Online-Sitzungen in einem neurorehabilitativen Zentrum


Schreiben Sie einen Kommentar