
Q-learning (Q-обучение) прошёл большой путь — от первых поведенческих экспериментов, таких как классическое обусловливание Павлова, до одной из важнейших техник машинного обучения (Machine Learning). Ниже мы рассмотрим, как он развивался и как применяется в нейрореабилитации и когнитивной стимуляции.
Эксперименты Павлова
Иван Павлов, русский физиолог конца XIX века, известен тем, что заложил основы поведенческой психологии своими экспериментами по классическому обусловливанию. В этих экспериментах Павлов показал, что собаки могут научиться связывать нейтральный стимул, например звук колокольчика, с безусловным стимулом, например едой, вызывая таким образом реакцию — слюноотделение.
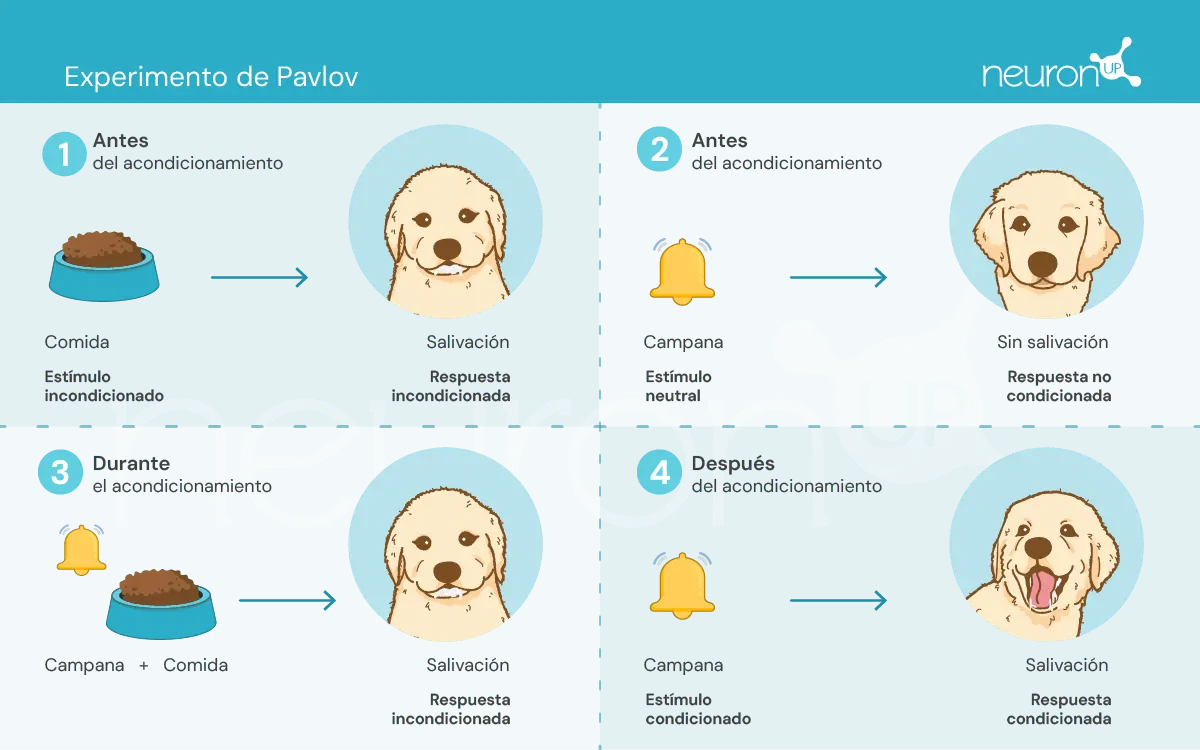
Этот эксперимент сыграл ключевую роль в доказательстве того, что поведение может приобретаться через ассоциации, — важнейшая идея, впоследствии повлиявшая на развитие теорий обучения с подкреплением.
Теории обучения с подкреплением
Эти теории изучают, как люди и животные усваивают поведение на основе последствий своих действий, что сыграло ключевую роль в создании таких алгоритмов, как Q-learning.
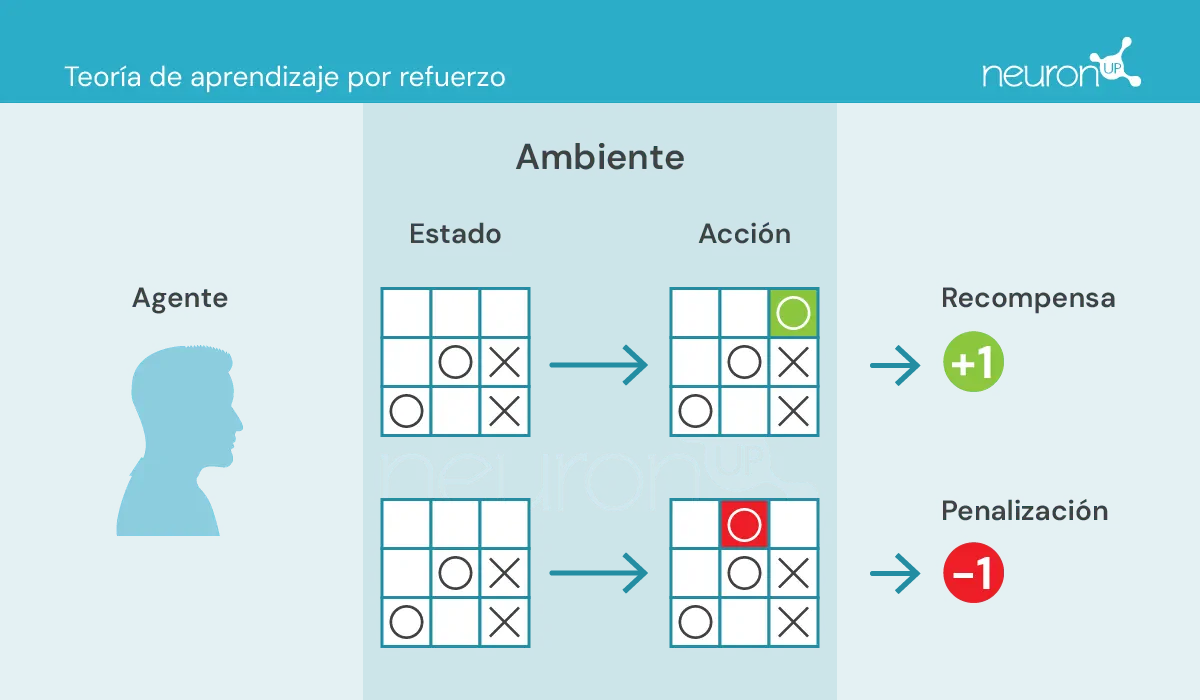
Прежде чем продолжить, нужно познакомиться с несколькими ключевыми понятиями:
- Агент: тот, кто выполняет действие.
- Среда: окружение, в котором агент движется и взаимодействует.
- Состояние: текущая ситуация в среде.
- Действие: возможные решения агента.
- Вознаграждение: награды, которые получает агент.
При таком обучении агент совершает действия в среде, получает информацию в виде вознаграждения/штрафа и использует её, чтобы со временем корректировать своё поведение.
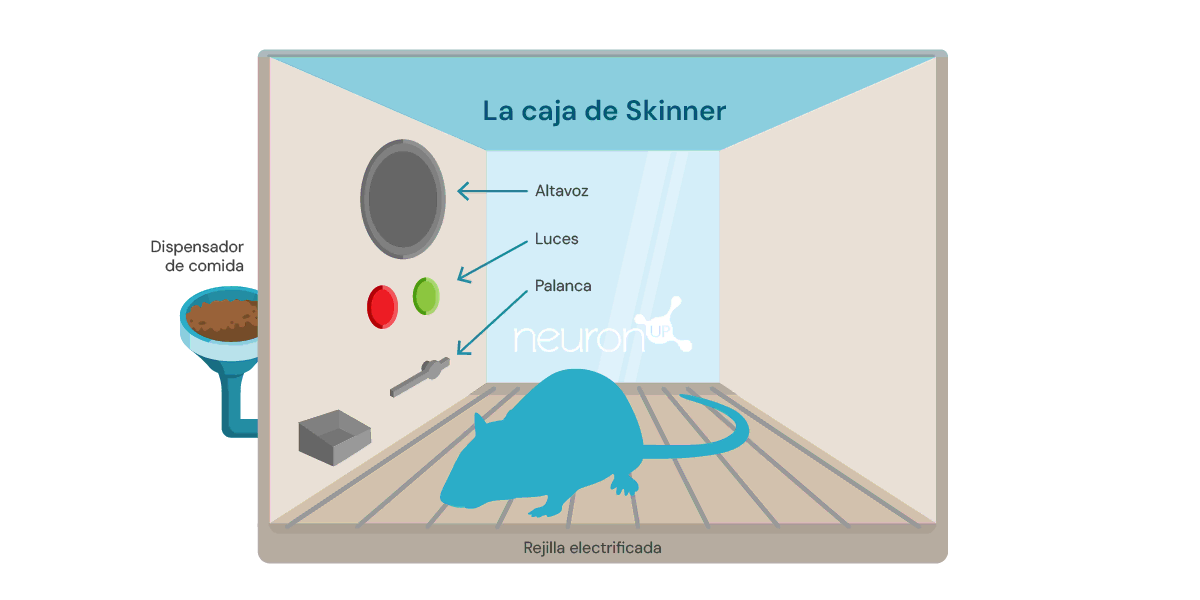
Классический эксперимент обучения с подкреплением — ящик Скиннера, созданный американским психологом Берресом Фредериком Скиннером в 1938 году. В этом эксперименте Скиннер показал, что крысы могут научиться нажимать на рычаг, чтобы получить еду, используя положительное подкрепление для формирования поведения.
Крысу помещают в ящик с рычагом, который она может нажать, кормушкой, а иногда лампочкой и динамиком.
Каждый раз, когда крыса нажимает на рычаг, в кормушку выпадает зёрнышко корма. Еда служит положительным подкреплением — наградой за нажатие рычага. Со временем крыса начинает нажимать на рычаг чаще, показывая, что усвоила поведение благодаря подкреплению.
Такое обучение легло в основу алгоритмов машинного обучения, таких как Q-learning, позволяющих машинам самостоятельно усваивать оптимальное поведение методом проб и ошибок.
Что такое Q-learning?
Q-learning был предложен Кристофером Уоткинсом в 1989 году как алгоритм обучения с подкреплением. Этот алгоритм позволяет агенту узнавать ценность действий в определённом состоянии, постоянно обновляя свои знания на основе опыта, — как крыса в ящике Скиннера.
В отличие от экспериментов Павлова, где обучение строилось на простых ассоциациях, Q-learning использует более сложный метод проб и ошибок. Агент исследует разные действия и обновляет Q-таблицу, в которой хранятся Q-значения — ожидаемые будущие вознаграждения за выбор лучшего действия в конкретном состоянии.
Q-learning применяется в разных сферах, например в рекомендательных системах (таких как у Netflix или Spotify), в автономных устройствах (например, дронах или роботах) и в оптимизации ресурсов. Теперь рассмотрим, как эту технологию можно применить в нейрореабилитации.
Q-learning и NeuronUP
Одно из преимуществ NeuronUP — возможность персонализировать задания в соответствии с конкретными потребностями каждого пользователя. Однако персонализация каждого задания может быть утомительной из-за большого числа настраиваемых параметров.
Q-learning позволяет автоматизировать этот процесс, настраивая параметры в зависимости от результатов пользователя в разных заданиях. Это гарантирует, что упражнения будут трудными, но выполнимыми, повышая эффективность и мотивацию в ходе реабилитации.
Как это работает?
В этом контексте агент, которого можно сравнить с пользователем, выполняющим задание, учится принимать оптимальные решения в разных ситуациях, чтобы успешно пройти задание.
Q-learning позволяет агенту пробовать разные действия, взаимодействуя со средой, получать вознаграждения или штрафы и обновлять Q-таблицу, в которой хранятся эти Q-значения. Эти значения представляют ожидаемые будущие вознаграждения за выбор лучшего действия в конкретном состоянии.
Правило обновления Q-learning выглядит так:
[Q(s,a) leftarrow Q(s,a) + alphabigl(r + gamma cdot max_{a’}bigl(Q(s’,a’)bigr) — Q(s,a)bigr)]Где:
𝛂 — скорость обучения.
r — вознаграждение, полученное после выполнения действия a из состояния s.
𝛄 — коэффициент дисконтирования, отражающий важность будущих вознаграждений.
s’ — следующее состояние.
(max_{a’}bigl(Q(s’,a’)bigr)) — максимальное Q-значение для следующего состояния s’.
Пример применения в задании NeuronUP
Возьмём задание NeuronUP «Перемешанные изображения», которое развивает такие навыки, как планирование, зрительно-конструктивный праксис и пространственные отношения. В этом задании нужно собрать пазл, который перемешали и разрезали на части.
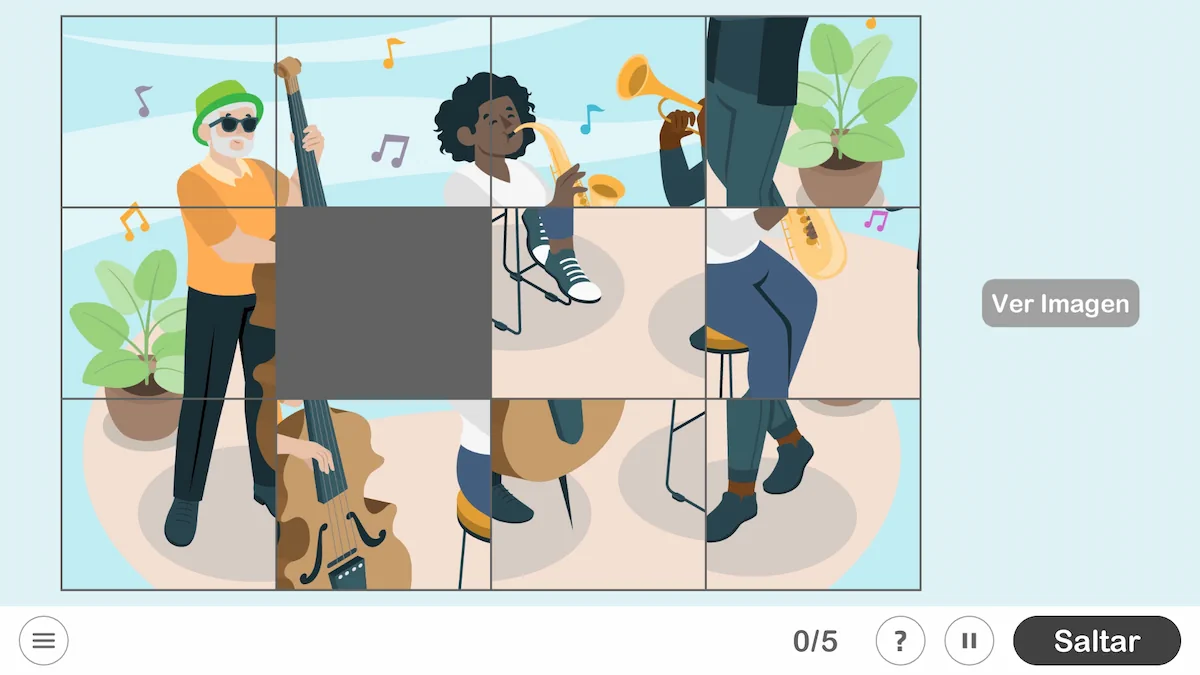
Сложность этого задания определяется размером матрицы (числом строк и столбцов) и степенью перемешивания деталей (низкая, средняя, высокая или очень высокая).
Чтобы обучить агента собирать пазл, была создана матрица вознаграждений на основе минимального числа ходов, необходимого для решения, которое определяется следующей формулой:
[mathrm{Min_Attempts} ;=;leftlceil frac{mathrm{factor} * mathrm{rows} * mathrm{columns}}{5}rightrceil,quad mathrm{factor}in{1,3,5,7}]Переменная factor зависит от степени перемешивания. После создания матрицы был применён алгоритм Q-learning, чтобы обучить агента автоматически собирать пазл.
Эта интеграция включает:
- Извлечение Q-значения: функция извлекает Q-значение для пары «состояние — действие» из Q-таблицы. Если пара ещё не обучалась, она возвращает 0. Эта функция ищет ожидаемое вознаграждение за выполнение конкретного действия в конкретном состоянии.
- Обновление Q-значения: функция обновляет Q-значение для пары «состояние — действие» на основе полученного вознаграждения и максимального Q-значения следующего состояния. Эта функция реализует упомянутое выше правило обновления Q-learning.
- Выбор действия: функция решает, какое действие выполнить в данном состоянии, используя ε-жадную стратегию. Эта стратегия уравновешивает исследование и использование:
- Исследование: состоит в том, чтобы пробовать действия, отличные от лучших известных, чтобы выяснить, не дадут ли они больше вознаграждения в будущем. С вероятностью ε (скорость исследования — значение от 0 до 1, определяющее вероятность исследовать новые действия вместо использования известных) выбирается случайное действие, что позволяет агенту находить потенциально лучшие действия.
- Использование: состоит в выборе лучшего известного на данный момент действия. С вероятностью 1−ε агент выбирает действие с наибольшим Q-значением для текущего состояния, опираясь на полученные знания: a’ = argmaxaQ(s,a). Где a’ — действие, максимизирующее функцию Q в данном состоянии s. Это означает, что в данном состоянии s выбирается действие a с наибольшим значением Q.
Эти функции работают вместе, позволяя алгоритму Q-learning выработать оптимальную стратегию сборки пазла.
Предварительный анализ работы алгоритма
Алгоритм применили к пазлу с матрицей 2×3 и коэффициентом сложности 1 (низкий), что соответствует минимальному числу попыток, равному 2. Алгоритм запускался на одном и том же пазле 20 раз с одинаковой конфигурацией перемешивания, обновляя Q-таблицу после каждого шага. После 20 запусков пазл перемешивался по-другому и процесс повторялся — всего 2000 итераций. Исходные значения параметров были такими:
- Вознаграждение за сборку пазла: 100 очков
- Штраф за каждый ход: −1 очко
На каждом шаге применялось дополнительное вознаграждение или штраф в зависимости от числа правильно расположенных деталей, что позволяло агенту понимать, насколько он продвинулся к решению. Это рассчитывалось по формуле:
[W times bigl(N_{mathrm{correct}}^i ;-; N_{mathrm{correct}}^{,i-1}bigr)]Где:
- W — весовой коэффициент.
- (N_{mathrm{correct}}^{,i}) — число правильно расположенных деталей после хода.
- (N_{mathrm{correct}}^{,i-1}) — число правильно расположенных деталей до хода.
На графике ниже показано число ходов, которое требуется модели на каждой итерации, чтобы собрать пазл размером 2×3. Вначале модели нужно много ходов, что отражает отсутствие знаний о том, как эффективно собрать пазл. Однако по мере обучения алгоритма Q-learning число ходов снижается, что говорит о том, что модель учится оптимизировать процесс решения.
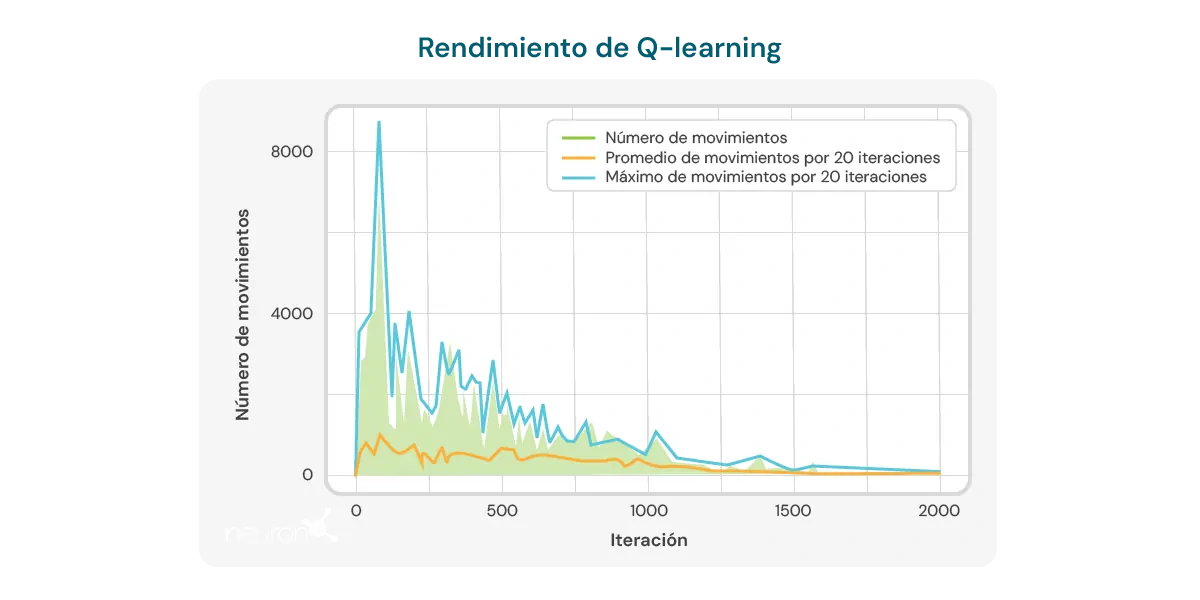

Эта тенденция — положительный признак потенциала алгоритма к улучшению со временем. Однако нужно учитывать ряд важных ограничений:
- Конкретный размер пазла: алгоритм эффективен в основном на пазлах определённого размера, например с матрицей 2×3. При изменении размера или сложности пазла его эффективность может значительно снизиться.
- Время вычислений: при применении алгоритма к другим или более сложным конфигурациям время вычислений и решения пазла значительно возрастает. Это ограничивает его применимость в ситуациях, требующих быстрого ответа, или для более сложных пазлов.
- По-прежнему большое число ходов: несмотря на наблюдаемое улучшение, число ходов, необходимых для сборки пазла, остаётся относительно большим даже после многих итераций. В последних запусках модели требуется в среднем 8–10 ходов, что указывает на возможности для повышения эффективности обучения.
Эти ограничения подчёркивают необходимость дальнейшей доработки алгоритма — настройки параметров обучения, улучшения структуры модели или включения дополнительных техник, обеспечивающих более эффективное обучение и адаптацию к разным конфигурациям пазлов. Несмотря на эти ограничения, не стоит забывать о преимуществах Q-learning в нейрореабилитации, среди которых:
- Динамическая персонализация заданий: Q-learning способен автоматически настраивать параметры терапевтических заданий в зависимости от индивидуальных результатов пользователя. Это значит, что задания можно персонализировать в реальном времени, чтобы каждый пользователь работал на трудном, но достижимом уровне. Это особенно полезно в нейрореабилитации, где возможности пользователей могут сильно различаться и меняться со временем.
- Рост мотивации и вовлечённости: поскольку задания постоянно подстраиваются под уровень навыков пользователя, удаётся избежать фрустрации от слишком трудных задач или скуки от слишком простых. Это может значительно повысить мотивацию пользователя и его вовлечённость в программу реабилитации, что крайне важно для успеха.
- Оптимизация процесса обучения: используя Q-learning, система может учиться на предыдущих взаимодействиях пользователя с заданиями, оптимизируя процесс обучения и реабилитации. Это делает упражнения эффективнее, фокусируя их на областях, требующих большего внимания, и сокращая время достижения терапевтических целей.
- Эффективность клинических решений: специалисты могут получать от Q-learning рекомендации на основе данных о том, как корректировать терапию. Это облегчает принятие более обоснованных и точных клинических решений, что, в свою очередь, повышает качество помощи пользователю.
- Постоянное совершенствование: со временем система на основе Q-learning может повышать свою эффективность за счёт накопления данных и опыта пользователя. Чем больше система используется, тем лучше она персонализирует и оптимизирует упражнения, давая долгосрочное преимущество в процессе нейрореабилитации.
В заключение, Q-learning прошёл путь от корней в поведенческой психологии до мощного инструмента искусственного интеллекта и нейрореабилитации. Способность самостоятельно адаптировать задания делает его ценным ресурсом для повышения эффективности реабилитационной терапии, хотя для полного раскрытия его возможностей ещё предстоит преодолеть ряд трудностей.
Библиография
- Bermejo Fernández, E. (2017). Aplicación de algoritmos de reinforcement learning a juegos.
- Giró Gràcia, X., & Sancho Gil, J. M. (2022). La Inteligencia Artificial en la educación: Big data, cajas negras y solucionismo tecnológico.
- Meyn, S. (2023). Stability of Q-learning through design and optimism. arXiv preprint arXiv:2307.02632.
- Morinigo, C., & Fenner, I. (2021). Teorías del aprendizaje. Minerva Magazine of Science, 9(2), 1-36.
- M.-V. Aponte, G. Levieux y S. Natkin. (2009). Measuring the level of difficulty in single player video games. Entertainment Computing.
- P. Jan L., H. Bruce D., P. Shashank, B. Corinne J., & M. Andrew P. (2019). The Effect of Adaptive Difficulty Adjustment on the Effectiveness of a Game to Develop Executive Function Skills for Learners of Different Ages. Cognitive Development, pp. 49, 56–67.
- R. Anna N., Z. Matei & G. Thomas L. Optimally Designing Games for Cognitive Science Research. Computer Science Division and Department of Psychology, University of California, Berkeley.
- Toledo Sánchez, M. (2024). Aplicaciones del aprendizaje por refuerzo en videojuegos.

 Разбирая синдром Майре
Добавить комментарий