
La dottoranda Marta Arbizu Gómez analizza le attuali evidenze scientifiche sui limiti dei modelli linguistici nel ragionamento clinico e sul loro impatto nella pratica clinica quotidiana.
Uno studio pubblicato su JAMA Network Open rivela che i modelli linguistici (LLM) superano l’80% di errore nella diagnosi differenziale, nonostante la loro accuratezza finale. Nella valutazione neuropsicologica e nella neuroriabilitazione, questi dati dimostrano che l’IA non sostituisce il ragionamento clinico umano e deve essere impiegata solo come strumento complementare sotto la supervisione di professionisti.
Perché è importante valutare il ragionamento clinico dell’intelligenza artificiale?
I modelli linguistici di grandi dimensioni, noti come LLM, stanno assumendo un ruolo sempre più importante in ambito sanitario. Vengono utilizzati o studiati per riassumere le cartelle cliniche, supportare il processo decisionale, rispondere a domande mediche, generare referti o aiutare nelle attività di documentazione clinica.
Tuttavia, una cosa è rispondere correttamente a una singola domanda medica e un’altra, molto diversa, è riprodurre il ragionamento clinico completo che un professionista sanitario applica davanti a un paziente reale. Nella pratica clinica, la diagnosi non deriva di solito da un’unica risposta, ma da un processo progressivo: si raccolgono informazioni, si formulano ipotesi, si richiedono esami, si escludono possibilità e si decide un piano di gestione.
Finora, molte valutazioni dell’intelligenza artificiale in medicina si sono basate su esami a risposta multipla, come le prove per l’abilitazione medica o le domande a scelta multipla. Sebbene questi formati siano utili per misurare le conoscenze, non colgono pienamente la complessità del ragionamento clinico, soprattutto in presenza di incertezza.
Lo studio pubblicato su JAMA Network Open affronta proprio questa questione: gli LLM attuali sono in grado di ragionare in modo affidabile lungo l’intero percorso clinico?
Iscriviti
alla nostra
Newsletter
Come è stata condotta la ricerca sugli LLM in medicina?
Gli autori hanno valutato le prestazioni di 21 modelli linguistici di ultima generazione utilizzando 29 vignette cliniche standardizzate tratte dal Manuale MSD. Queste vignette simulano casi clinici passo dopo passo, dalla presentazione iniziale del paziente fino alla diagnosi e alla gestione.
I modelli valutati comprendevano sistemi di diverse famiglie, come GPT, Claude, Gemini, DeepSeek e Grok. Tra questi vi erano modelli recenti e ottimizzati per il ragionamento, come GPT-5, Claude 4.5 Opus, Gemini 3.0 Pro e Grok 4.
Ogni modello doveva rispondere a domande organizzate in cinque domini del ragionamento clinico:
- Diagnosi differenziale;
- esami diagnostici;
- diagnosi finale;
- gestione o trattamento;
- e ulteriori domande cliniche.
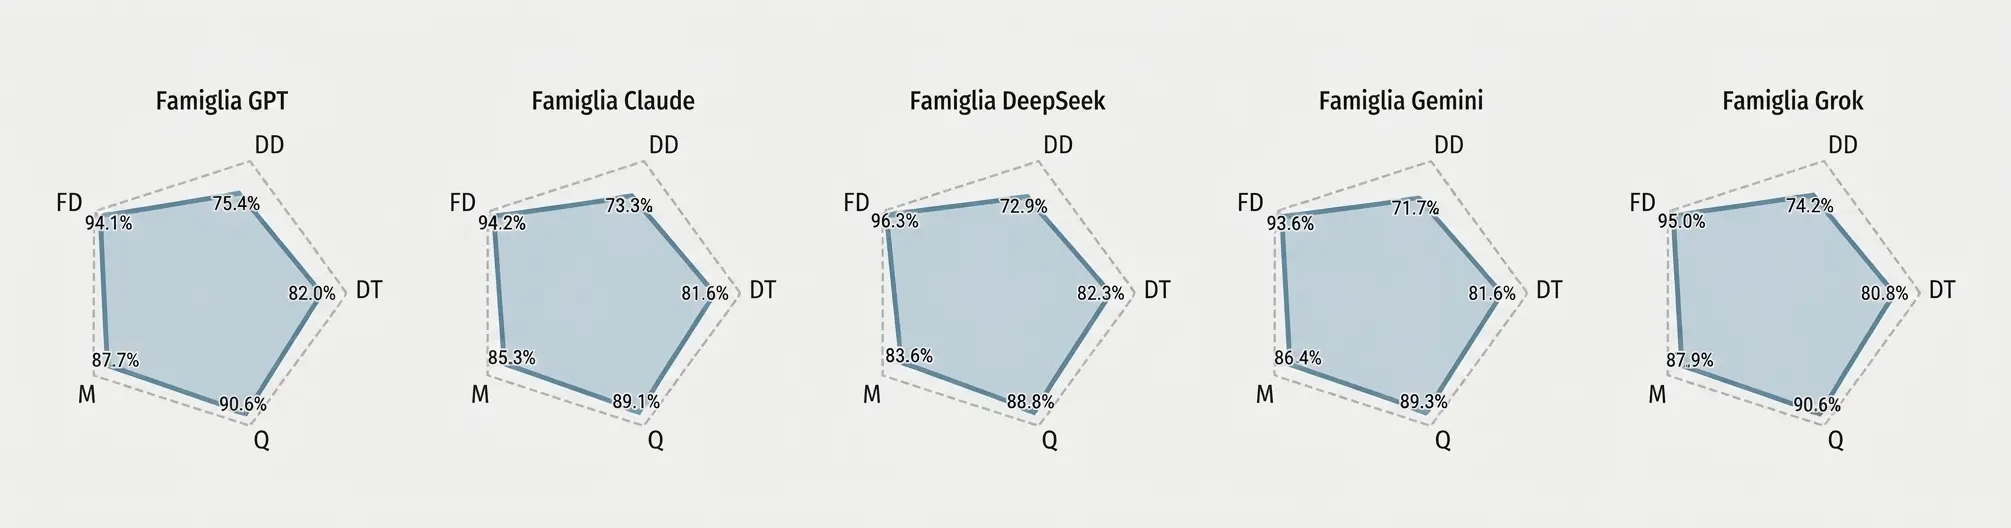
Per valutare le prestazioni, i ricercatori non si sono limitati a calcolare l’accuratezza complessiva. Hanno introdotto una nuova metrica chiamata PrIME-LLM, che riassume le prestazioni equilibrate del modello in cinque aree del ragionamento clinico. Questa metrica è rappresentata mediante grafici radar: quanto più ampia ed equilibrata è l’area del grafico, tanto migliori sono le prestazioni del modello lungo l’intero processo clinico.
Cosa rivelano i risultati chiave sugli LLM nella diagnosi?
I risultati mostrano un quadro molto chiaro: gli LLM attuali possono ottenere buoni risultati quando viene loro chiesto di identificare la diagnosi finale, ma incontrano molte più difficoltà quando devono elaborare una diagnosi differenziale.
Questo aspetto è particolarmente rilevante, perché la diagnosi differenziale è una componente centrale del ragionamento medico. Consiste nel considerare diverse possibilità diagnostiche, mantenere l’incertezza ed evitare di chiudere il caso troppo presto. Secondo gli autori, i modelli tendono a convergere prematuramente verso un’unica risposta, invece di ragionare in modo più flessibile come farebbe un clinico.
I modelli ottimizzati per il ragionamento hanno ottenuto risultati migliori rispetto a quelli non ottimizzati, ma questo miglioramento non ha eliminato i principali limiti. Anche i modelli più avanzati hanno continuato a mostrare errori importanti nelle fasi iniziali del ragionamento clinico.
Nel complesso, i migliori risultati in PrIME-LLM sono stati ottenuti da modelli come Grok 4, GPT-5, GPT-4.5, Claude 4.5 Opus, Gemini 3.0 Flash e Gemini 3.0 Pro. Tuttavia, lo studio avverte che un’elevata accuratezza complessiva può nascondere debolezze importanti se il modello non offre prestazioni equilibrate in tutte le attività.
| Metrica o risultato | Principale evidenza |
|---|---|
| Modelli valutati | 21 LLM |
| Casi clinici utilizzati | 29 vignette cliniche |
| Totale delle risposte analizzate | 16.254 |
| Migliori prestazioni complessive | Modelli recenti e ottimizzati per il ragionamento |
| Area più forte | Diagnosi finale |
| Area più debole | Diagnosi differenziale |
| Tasso di errore nella diagnosi differenziale | Superiore a 0,80 in tutti i modelli |
| Utilità di PrIME-LLM | Rileva squilibri che l’accuratezza complessiva può nascondere |
| Conclusione clinica | Gli LLM non sono sicuri per l’uso autonomo senza supervisione |
Quali implicazioni ha per la pratica clinica?
Questo studio lancia un avvertimento importante: non è sufficiente che un modello indovini le diagnosi finali per considerarlo sicuro in medicina.
Nella pratica clinica, uno dei rischi maggiori è che uno strumento generi una risposta apparentemente corretta senza aver considerato adeguatamente altre possibilità. Ciò può creare un falso senso di sicurezza, soprattutto in contesti caratterizzati da elevata incertezza.
I risultati suggeriscono che gli LLM possono essere utili in attività cliniche specifiche, soprattutto quando sono ben delimitate e supervisionate da professionisti. Per esempio, potrebbero aiutare a riassumere informazioni, strutturare dati, supportare la revisione della documentazione o fungere da strumento complementare in contesti a bassa incertezza.
Tuttavia, gli autori sono chiari: i modelli attuali non dovrebbero essere utilizzati come agenti diagnostici autonomi né in contesti patient-facing senza supervisione clinica. Le loro prestazioni non riproducono ancora la complessità del ragionamento medico umano, soprattutto nelle fasi iniziali della diagnosi.
Come si collega questo progresso a NeuronUP?
In NeuronUP lavoriamo con strumenti digitali basati sull’evidenza e orientati alla riabilitazione e alla stimolazione cognitiva. In questo contesto, studi come questo sono particolarmente rilevanti perché contribuiscono a definire il ruolo realistico dell’intelligenza artificiale nella salute.
L’IA può apportare valore quando viene integrata in modo responsabile, trasparente e supervisionato. Per esempio, può contribuire a:
- Supportare l’organizzazione delle informazioni cliniche e funzionali.
- Facilitare il monitoraggio strutturato dei pazienti.
- Aiutare a personalizzare gli interventi cognitivi sulla base di dati oggettivi.
- Integrare, ma non sostituire, il giudizio dei professionisti.
Questo articolo rafforza un’idea chiave: la tecnologia sanitaria deve essere valutata non solo per la sua capacità di fornire risposte corrette, ma anche per la sua sicurezza, affidabilità e utilità all’interno dell’intero processo clinico.
Nel caso della neuroriabilitazione, ciò significa procedere verso modelli in cui l’intelligenza artificiale possa supportare il processo decisionale, ma sempre integrata in équipe professionali e sulla base di criteri clinici chiari.
Prova NeuronUP gratis per 7 giorni
Potrai collaborare con le nostre attività, progettare sedute o fare riabilitazione a distanza.
Conclusioni
Lo studio mostra che i modelli linguistici hanno compiuto notevoli progressi e possono ottenere buoni risultati in attività mediche specifiche. Tuttavia, continuano a presentare importanti limiti nel ragionamento clinico longitudinale, soprattutto nella formulazione di diagnosi differenziali e nella gestione dell’incertezza.
La nuova metrica PrIME-LLM consente di valutare questi modelli in modo più completo rispetto all’accuratezza complessiva, poiché identifica gli squilibri tra le diverse fasi del processo clinico.
In definitiva, gli LLM possono essere strumenti promettenti per supportare determinati processi sanitari, ma non sono ancora pronti a sostituire il ragionamento clinico umano né a prendere decisioni diagnostiche in modo autonomo.
Bibliografia
- Rao AS, Esmail KP, Lee RS, Jiang S, Arraiza Carlo B, Gill J, Khanna P, Kalmowitz E, Montagnese B, Heydari K, Jiao Q, Bott E, Nguyen D, Wang G, Hood M, Landman AB, Succi MD. Large Language Model Performance and Clinical Reasoning Tasks. JAMA Network Open. 2026;9(4):e264003. doi:10.1001/jamanetworkopen.2026.4003.
Domande frequenti sugli LLM in medicina
1. I modelli linguistici (LLM) possono effettuare diagnosi cliniche in modo autonomo?
No. I modelli valutati presentano un tasso di errore superiore all’80% nella formulazione di diagnosi differenziali e mostrano la tendenza a convergere prematuramente verso un’unica opzione. Pertanto, non sono sicuri per operare autonomamente senza la supervisione diretta di un professionista sanitario.
2. Che cos’è la metrica PrIME-LLM e perché è importante?
È una metrica progettata per valutare le prestazioni equilibrate dei modelli in cinque domini del processo clinico: diagnosi differenziale, esami, diagnosi finale, trattamento e domande aggiuntive. La sua importanza risiede nella capacità di rilevare debolezze e squilibri del ragionamento che le metriche tradizionali di accuratezza complessiva tendono a nascondere.
3. Quali sono i principali limiti dell’intelligenza artificiale nel percorso clinico?
Sebbene le famiglie di modelli avanzati, come GPT, Claude, Gemini, Grok o DeepSeek, siano efficaci nell’identificare la diagnosi finale, subiscono un grave calo nelle fasi iniziali. Il loro limite principale è l’incapacità di gestire l’incertezza diagnostica e di considerare diverse ipotesi prima di chiudere un caso.
4. Quali implicazioni hanno questi risultati per la valutazione e la riabilitazione cognitiva?
Lo studio dimostra che l’IA non deve sostituire il giudizio professionale nella valutazione neuropsicologica. Tuttavia, la tecnologia rimane un eccellente strumento complementare per organizzare le informazioni cliniche, personalizzare gli interventi cognitivi e ottimizzare la documentazione del paziente secondo il giudizio dello specialista.

 Guida per professionisti: come affrontare la dislessia nei bambini con ADHD secondo la neuropsicologia basata sull’evidenza
Lascia un commento