
Докторантка Марта Арбису Гомес анализирует современные научные данные об ограничениях языковых моделей в клиническом рассуждении и их влиянии на повседневную клиническую практику.
Исследование, опубликованное в JAMA Network Open, показывает, что доля ошибок языковых моделей (LLM) в дифференциальной диагностике превышает 80 %, несмотря на точность итогового диагноза. Для нейропсихологической оценки и нейрореабилитации эти данные показывают, что ИИ не заменяет клиническое рассуждение человека и должен использоваться только как вспомогательный инструмент под контролем специалиста.
Почему важно оценивать клиническое рассуждение искусственного интеллекта?
Большие языковые модели, известные как LLM, играют всё более заметную роль в здравоохранении. Их используют или изучают для составления резюме историй болезни, поддержки принятия решений, ответов на медицинские вопросы, подготовки отчётов или помощи в клинической документации.
Однако правильно ответить на отдельный медицинский вопрос — это одно, а воспроизвести полное клиническое рассуждение, которое проводит медицинский специалист перед реальным пациентом, — совсем другое. В клинической практике диагноз обычно рождается не из одного ответа, а из последовательного процесса: собирается информация, выдвигаются гипотезы, назначаются исследования, исключаются варианты и выбирается план ведения.
До сих пор многие оценки искусственного интеллекта в медицине основывались на тестовых экзаменах, таких как экзамены на получение медицинской лицензии или вопросы с несколькими вариантами ответа. Хотя эти форматы полезны для измерения знаний, они не вполне отражают сложность клинического рассуждения, особенно в условиях неопределённости.
Исследование, опубликованное в JAMA Network Open, посвящено именно этому вопросу: могут ли современные LLM надёжно рассуждать на протяжении всего клинического процесса?
Как проводилось исследование LLM в медицине?
Авторы оценили работу 21 языковой модели последнего поколения на 29 стандартизированных клинических виньетках из справочника MSD Manual. Эти виньетки пошагово моделируют клинические случаи — от первичного обращения пациента до диагноза и ведения.
Среди оцениваемых моделей были системы разных семейств, таких как GPT, Claude, Gemini, DeepSeek и Grok, в том числе недавние модели, оптимизированные для рассуждения, например GPT-5, Claude 4.5 Opus, Gemini 3.0 Pro или Grok 4.
Каждая модель должна была отвечать на вопросы, сгруппированные в пять областей клинического рассуждения:
- дифференциальная диагностика;
- диагностические исследования;
- итоговый диагноз;
- ведение или лечение;
- и дополнительные клинические вопросы.
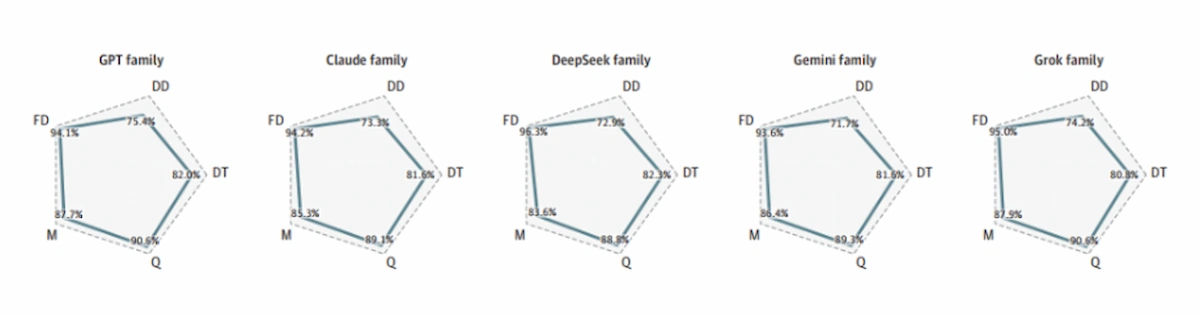
Для оценки работы исследователи не ограничились расчётом общей точности. Они ввели новую метрику PrIME-LLM, обобщающую сбалансированность работы модели в пяти областях клинического рассуждения. Эта метрика изображается с помощью лепестковых диаграмм: чем шире и равномернее площадь диаграммы, тем лучше модель работает на протяжении всего клинического процесса.
Что показывают ключевые результаты о LLM в диагностике?
Результаты демонстрируют очень чёткую закономерность: современные LLM могут хорошо справляться, когда их просят определить итоговый диагноз, но испытывают гораздо больше трудностей, когда нужно провести дифференциальную диагностику.
Это особенно важно, поскольку дифференциальная диагностика — центральная часть медицинского рассуждения. Она состоит в рассмотрении различных диагностических вариантов, сохранении неопределённости и отказе от слишком раннего закрытия случая. По словам авторов, модели склонны преждевременно сходиться к одному ответу вместо того, чтобы рассуждать гибко, как это делал бы клиницист.
Модели, оптимизированные для рассуждения, показали лучшие результаты, чем неоптимизированные, но это улучшение не устранило основных ограничений. Даже самые продвинутые модели продолжали допускать серьёзные ошибки на ранних этапах клинического рассуждения.
В целом лучшие результаты по PrIME-LLM показали такие модели, как Grok 4, GPT-5, GPT-4.5, Claude 4.5 Opus, Gemini 3.0 Flash и Gemini 3.0 Pro. Однако исследование предупреждает, что высокая общая точность может скрывать серьёзные слабые места, если модель работает несбалансированно в разных задачах.
| Метрика или результат | Основной вывод |
|---|---|
| Оцениваемые модели | 21 LLM |
| Использованные клинические случаи | 29 клинических виньеток |
| Всего проанализировано ответов | 16.254 |
| Лучшие общие результаты | Недавние модели, оптимизированные для рассуждения |
| Самая сильная область | Итоговый диагноз |
| Самая слабая область | Дифференциальная диагностика |
| Доля ошибок в дифференциальной диагностике | Выше 0,80 у всех моделей |
| Польза PrIME-LLM | Выявляет дисбалансы, которые может скрывать общая точность |
| Клинический вывод | LLM небезопасны для самостоятельного использования без контроля |
Каково значение для клинической практики?
Это исследование содержит важное предупреждение: недостаточно, чтобы модель правильно ставила итоговые диагнозы, чтобы считать её безопасной в медицине.
В клинической практике один из главных рисков состоит в том, что инструмент выдаст на вид правильный ответ, не рассмотрев должным образом другие варианты. Это может создать ложное ощущение безопасности, особенно в условиях высокой неопределённости.
Результаты предполагают, что LLM могут быть полезны в отдельных клинических задачах, особенно если они чётко очерчены и выполняются под контролем специалистов. Например, они могли бы помогать резюмировать информацию, структурировать данные, поддерживать проверку документации или служить вспомогательным инструментом в условиях низкой неопределённости.
Однако авторы высказываются однозначно: современные модели не следует использовать как самостоятельных диагностических агентов или в работе напрямую с пациентами без клинического контроля. Их работа пока не воспроизводит сложность медицинского рассуждения человека, особенно на начальных этапах диагностики.
Как это открытие связано с NeuronUP?
В NeuronUP мы работаем с научно обоснованными цифровыми инструментами для когнитивной реабилитации и стимуляции. В этом контексте подобные исследования особенно важны, поскольку помогают определить реалистичную роль искусственного интеллекта в здравоохранении.
ИИ может приносить пользу, если внедряется ответственно, прозрачно и под контролем. Например, он может помогать:
- организовывать клиническую и функциональную информацию;
- облегчать структурированное наблюдение за пациентами;
- персонализировать когнитивные вмешательства на основе объективных данных;
- дополнять, но не заменять суждение специалистов.
Эта статья подкрепляет ключевую идею: медицинские технологии нужно оценивать не только по способности давать правильные ответы, но и по их безопасности, надёжности и полезности в рамках всего клинического процесса.
В нейрореабилитации это означает движение к моделям, в которых искусственный интеллект может поддерживать принятие решений, но всегда в составе профессиональных команд и при чётких клинических критериях.
Заключение
Исследование показывает, что языковые модели заметно продвинулись и могут хорошо справляться с отдельными медицинскими задачами. Однако у них сохраняются серьёзные ограничения в продольном клиническом рассуждении, особенно при построении дифференциальных диагнозов и работе с неопределённостью.
Новая метрика PrIME-LLM позволяет оценивать эти модели полнее, чем общая точность, поскольку выявляет дисбалансы между разными этапами клинического процесса.
В итоге LLM могут быть перспективными инструментами для поддержки отдельных медицинских процессов, но пока не готовы заменить клиническое рассуждение человека или самостоятельно принимать диагностические решения.
Библиография
- Rao AS, Esmail KP, Lee RS, Jiang S, Arraiza Carlo B, Gill J, Khanna P, Kalmowitz E, Montagnese B, Heydari K, Jiao Q, Bott E, Nguyen D, Wang G, Hood M, Landman AB, Succi MD. Large Language Model Performance and Clinical Reasoning Tasks. JAMA Network Open. 2026;9(4):e264003. doi:10.1001/jamanetworkopen.2026.4003.
Часто задаваемые вопросы о LLM в медицине
1. Могут ли языковые модели (LLM) самостоятельно ставить клинические диагнозы?
Нет. У оцененных моделей доля ошибок при построении дифференциальных диагнозов превышает 80 %, и они склонны преждевременно сходиться к одному варианту. Поэтому они небезопасны для самостоятельной работы без прямого контроля медицинского специалиста.
2. Что такое метрика PrIME-LLM и почему она важна?
Это метрика, предназначенная для оценки сбалансированности работы моделей в пяти областях клинического процесса: дифференциальная диагностика, исследования, итоговый диагноз, лечение и дополнительные вопросы. Её важность в том, что она выявляет слабые места и дисбалансы в рассуждении, которые обычно скрывают традиционные метрики общей точности.
3. Каковы основные ограничения искусственного интеллекта в клиническом процессе?
Хотя семейства продвинутых моделей (такие как GPT, Claude, Gemini, Grok или DeepSeek) хорошо определяют итоговый диагноз, на начальных этапах их результаты резко ухудшаются. Главное ограничение — неспособность справляться с диагностической неопределённостью и рассматривать разные гипотезы, прежде чем закрыть случай.
4. Какое значение имеют эти данные для когнитивной оценки и реабилитации?
Исследование показывает, что ИИ не должен заменять профессиональное суждение при нейропсихологической оценке. Тем не менее технологии остаются прекрасным вспомогательным ресурсом для организации клинической информации, персонализации когнитивных вмешательств и оптимизации документации пациента под руководством специалиста.


 Руководство для специалистов: как подходить к дислексии у детей с СДВГ на основе доказательной нейропсихологии

Добавить комментарий