
La doctorante Marta Arbizu Gómez analyse les données scientifiques actuelles sur les limites des modèles de langage en matière de raisonnement clinique et leur impact sur la pratique clinique quotidienne.
Une étude publiée dans JAMA Network Open révèle que les modèles de langage (LLM) dépassent un taux d’erreur de 80 % dans le diagnostic différentiel, malgré leur précision finale. En évaluation neuropsychologique et en neurorééducation, ces données démontrent que l’IA ne remplace pas le raisonnement clinique humain et doit être utilisée uniquement comme outil complémentaire sous supervision professionnelle.
Pourquoi est-il important d’évaluer le raisonnement clinique de l’intelligence artificielle ?
Les modèles de langage de grande taille, connus sous le nom de LLM, occupent une place de plus en plus importante dans le domaine de la santé. Ils sont utilisés ou étudiés pour résumer des dossiers médicaux, soutenir la prise de décision, répondre à des questions médicales, rédiger des comptes rendus ou aider dans les tâches de documentation clinique.
Cependant, répondre correctement à une question médicale isolée est une chose, reproduire l’ensemble du raisonnement clinique d’un professionnel de santé face à un patient réel en est une autre. En pratique clinique, le diagnostic ne découle généralement pas d’une réponse unique, mais d’un processus progressif : les informations sont recueillies, des hypothèses sont formulées, des examens sont prescrits, des possibilités sont écartées et un plan de prise en charge est défini.
Jusqu’à présent, de nombreuses évaluations de l’intelligence artificielle en médecine reposaient sur des examens à choix multiples, tels que des épreuves de licence médicale ou des questions à choix multiple. Bien que ces formats soient utiles pour mesurer les connaissances, ils ne rendent pas pleinement compte de la complexité du raisonnement clinique, notamment en situation d’incertitude.
L’étude publiée dans JAMA Network Open s’intéresse précisément à cette question : les LLM actuels peuvent-ils raisonner de manière fiable tout au long du parcours clinique ?
Abonnez-vous
à notre
Newsletter
Comment l’étude sur les LLM en médecine a-t-elle été menée ?
Les auteurs ont évalué les performances de 21 modèles de langage de dernière génération à l’aide de 29 vignettes cliniques standardisées provenant du MSD Manual. Ces vignettes simulent des cas cliniques étape par étape, de la présentation initiale du patient au diagnostic et à la prise en charge.
Les modèles évalués comprenaient des systèmes issus de différentes familles, telles que GPT, Claude, Gemini, DeepSeek et Grok. Parmi eux figuraient des modèles récents et optimisés pour le raisonnement, comme GPT-5, Claude 4.5 Opus, Gemini 3.0 Pro ou Grok 4.
Chaque modèle devait répondre à des questions organisées autour de cinq domaines du raisonnement clinique :
- Diagnostic différentiel ;
- examens diagnostiques ;
- diagnostic final ;
- prise en charge ou traitement ;
- et questions cliniques supplémentaires.
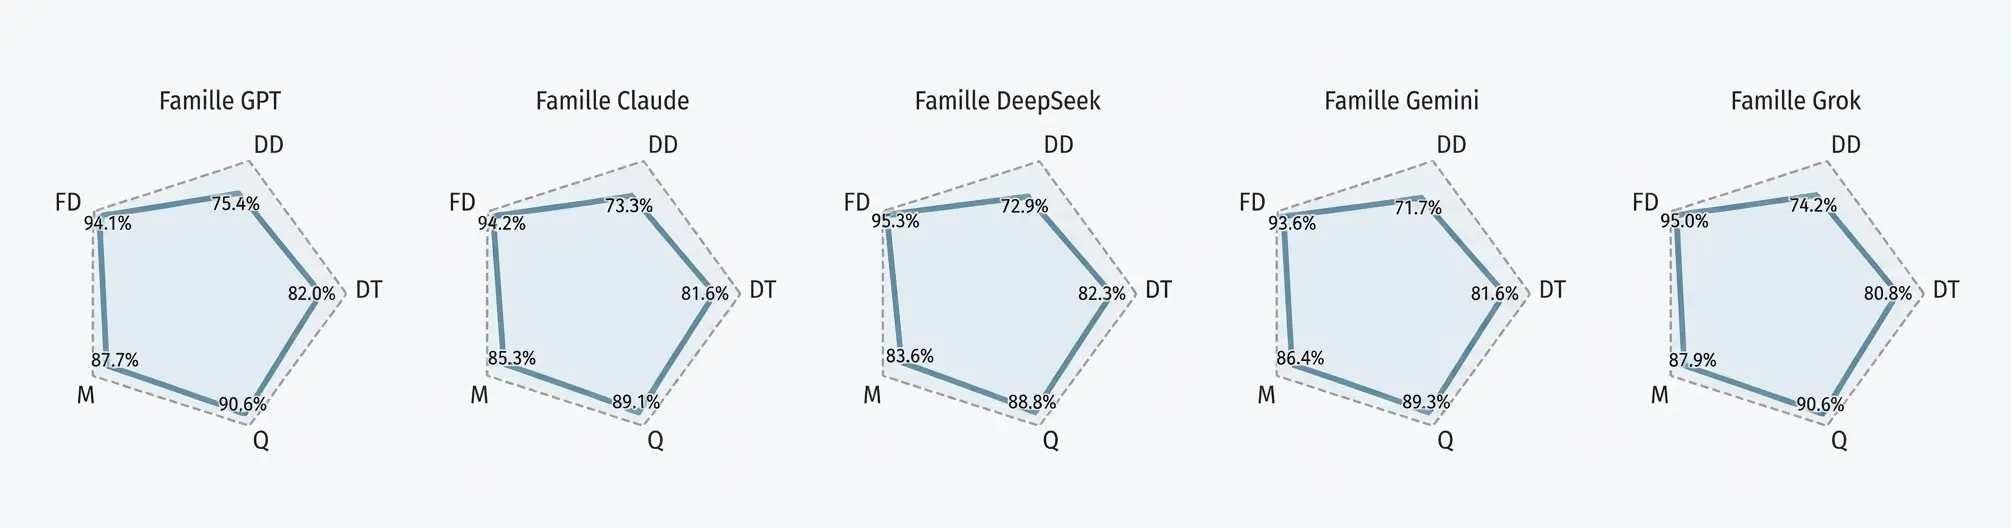
Pour évaluer les performances, les chercheurs ne se sont pas limités à calculer la précision globale. Ils ont introduit une nouvelle métrique appelée PrIME-LLM, qui synthétise les performances équilibrées du modèle dans cinq domaines du raisonnement clinique. Cette métrique est représentée par des graphiques en radar : plus la surface du graphique est large et équilibrée, meilleures sont les performances du modèle tout au long du processus clinique.
Que révèlent les principaux résultats sur les LLM dans le diagnostic ?
Les résultats montrent une tendance très nette : les LLM actuels peuvent obtenir de bons résultats lorsqu’on leur demande d’identifier le diagnostic final, mais rencontrent beaucoup plus de difficultés lorsqu’ils doivent établir un diagnostic différentiel.
Ce point est particulièrement important, car le diagnostic différentiel constitue une composante centrale du raisonnement médical. Il consiste à envisager différentes possibilités diagnostiques, à maintenir l’incertitude et à éviter de conclure trop rapidement. Selon les auteurs, les modèles tendent à converger prématurément vers une réponse unique, au lieu de raisonner de manière plus souple comme le ferait un clinicien.
Les modèles optimisés pour le raisonnement ont obtenu de meilleurs résultats que les modèles non optimisés, mais cette amélioration n’a pas supprimé les principales limites. Même les modèles les plus avancés ont continué à présenter des défaillances importantes dans les premières phases du raisonnement clinique.
Dans l’ensemble, les meilleurs résultats au PrIME-LLM ont été obtenus par des modèles tels que Grok 4, GPT-5, GPT-4.5, Claude 4.5 Opus, Gemini 3.0 Flash et Gemini 3.0 Pro. Cependant, l’étude avertit qu’une précision globale élevée peut masquer des faiblesses importantes si le modèle n’obtient pas des performances équilibrées dans toutes les tâches.
| Métrique ou résultat | Principal constat |
|---|---|
| Modèles évalués | 21 LLM |
| Cas cliniques utilisés | 29 vignettes cliniques |
| Nombre total de réponses analysées | 16 254 |
| Meilleures performances générales | Modèles récents et optimisés pour le raisonnement |
| Domaine le plus performant | Diagnostic final |
| Domaine le plus faible | Diagnostic différentiel |
| Taux d’échec dans le diagnostic différentiel | Supérieur à 0,80 pour tous les modèles |
| Utilité du PrIME-LLM | Détecte les déséquilibres que la précision globale peut masquer |
| Conclusion clinique | Les LLM ne sont pas sûrs pour une utilisation autonome sans supervision |
Quelles sont les implications pour la pratique clinique ?
Cette étude formule une mise en garde importante : il ne suffit pas qu’un modèle établisse correctement les diagnostics finaux pour le considérer comme sûr en médecine.
En pratique clinique, l’un des principaux risques est qu’un outil génère une réponse apparemment correcte sans avoir correctement pris en compte d’autres possibilités. Cela peut créer un faux sentiment de sécurité, notamment dans les contextes de forte incertitude.
Les résultats suggèrent que les LLM peuvent être utiles pour certaines tâches cliniques précises, en particulier lorsqu’elles sont clairement délimitées et supervisées par des professionnels. Ils pourraient par exemple aider à résumer des informations, structurer des données, soutenir la revue de documents ou servir d’outil complémentaire dans des environnements où l’incertitude est faible.
Cependant, les auteurs sont clairs : les modèles actuels ne devraient pas être utilisés comme agents diagnostiques autonomes ni dans des contextes patient-facing sans supervision clinique. Leurs performances ne reproduisent toujours pas la complexité du raisonnement médical humain, notamment dans les premières phases du diagnostic.
Quel est le lien entre cette avancée et NeuronUP ?
Chez NeuronUP , nous travaillons avec des outils numériques fondés sur des données probantes et destinés à la rééducation et à la stimulation cognitive. Dans ce contexte, des études comme celle-ci sont particulièrement pertinentes, car elles contribuent à définir le rôle réaliste de l’intelligence artificielle dans le domaine de la santé.
L’IA peut apporter une réelle valeur lorsqu’elle est intégrée de manière responsable, transparente et supervisée. Elle peut notamment contribuer à :
- Soutenir l’organisation des informations cliniques et fonctionnelles.
- Faciliter le suivi structuré des patients.
- Aider à personnaliser les interventions cognitives à partir de données objectives.
- Compléter, mais non remplacer, le jugement des professionnels.
Cet article renforce une idée essentielle : les technologies de santé doivent être évaluées non seulement selon leur capacité à fournir des réponses correctes, mais aussi selon leur sécurité, leur fiabilité et leur utilité dans l’ensemble du processus clinique.
Dans le cas de la neurorééducation, cela implique d’évoluer vers des modèles dans lesquels l’intelligence artificielle peut soutenir la prise de décision, mais toujours au sein d’équipes professionnelles et selon des critères cliniques clairs.
Essayez NeuronUP 7 jours gratuitement
Vous pourrez travailler avec nos activités, concevoir des séances ou effectuer des réhabilitations à distance
Conclusion
L’étude montre que les modèles de langage ont considérablement progressé et peuvent obtenir de bons résultats dans certaines tâches médicales. Cependant, ils présentent encore d’importantes limites dans le raisonnement clinique longitudinal, notamment pour établir des diagnostics différentiels et gérer l’incertitude.
La nouvelle métrique PrIME-LLM permet d’évaluer ces modèles de manière plus complète que la précision globale, car elle identifie les déséquilibres entre les différentes étapes du processus clinique.
En définitive, les LLM peuvent constituer des outils prometteurs pour soutenir certains processus de santé, mais ils ne sont pas encore prêts à remplacer le raisonnement clinique humain ni à prendre des décisions diagnostiques de manière autonome.
Bibliographie
- Rao AS, Esmail KP, Lee RS, Jiang S, Arraiza Carlo B, Gill J, Khanna P, Kalmowitz E, Montagnese B, Heydari K, Jiao Q, Bott E, Nguyen D, Wang G, Hood M, Landman AB, Succi MD. Large Language Model Performance and Clinical Reasoning Tasks. JAMA Network Open. 2026;9(4):e264003. doi:10.1001/jamanetworkopen.2026.4003.
Questions fréquentes sur les LLM en médecine
1. Les modèles de langage (LLM) peuvent-ils établir des diagnostics cliniques de manière autonome ?
Non. Les modèles évalués présentent un taux d’échec supérieur à 80 % pour établir des diagnostics différentiels et tendent à converger prématurément vers une seule option. Ils ne sont donc pas suffisamment sûrs pour fonctionner de manière autonome sans la supervision directe d’un professionnel de santé.
2. Qu’est-ce que la métrique PrIME-LLM et pourquoi est-elle importante ?
Il s’agit d’une métrique conçue pour évaluer les performances équilibrées des modèles dans cinq domaines du processus clinique : diagnostic différentiel, examens, diagnostic final, traitement et questions supplémentaires. Elle est importante car elle détecte des faiblesses et des déséquilibres du raisonnement que les métriques traditionnelles de précision globale tendent à masquer.
3. Quelles sont les principales limites de l’intelligence artificielle dans le parcours clinique ?
Bien que les familles de modèles avancés, telles que GPT, Claude, Gemini, Grok ou DeepSeek, soient performantes pour identifier le diagnostic final, elles connaissent un net recul dans les premières phases. Leur principale limite est leur incapacité à gérer l’incertitude diagnostique et à envisager différentes hypothèses avant de conclure.
4. Quelles sont les implications de ces résultats pour l’évaluation et la rééducation cognitive ?
L’étude montre que l’IA ne doit pas remplacer le jugement professionnel lors de l’évaluation neuropsychologique. Toutefois, la technologie reste une excellente ressource complémentaire pour organiser les informations cliniques, personnaliser les interventions cognitives et optimiser la documentation du patient, sous la responsabilité du spécialiste.

 Guide pour les professionnels : prendre en charge la dyslexie chez les enfants présentant un TDAH selon une neuropsychologie fondée sur les preuves


Laisser un commentaire