
A doutoranda Marta Arbizu Gómez analisa as evidências científicas atuais sobre as limitações dos modelos de linguagem no raciocínio clínico e seu impacto na prática clínica diária.
Um estudo publicado na JAMA Network Open revela que os modelos de linguagem (LLMs) superam 80% de erro no diagnóstico diferencial, apesar de sua precisão final. Na avaliação neuropsicológica e na neurorreabilitação, esses dados demonstram que a IA não substitui o raciocínio clínico humano e deve ser empregada apenas como ferramenta complementar sob supervisão profissional.
Por que é importante avaliar o raciocínio clínico da inteligência artificial?
Os modelos de linguagem de grande porte, conhecidos como LLMs, estão ganhando cada vez mais destaque na área da saúde. Eles são usados ou estão sendo estudados para resumir prontuários, apoiar a tomada de decisões, responder a perguntas médicas, gerar relatórios ou auxiliar em tarefas de documentação clínica.
No entanto, uma coisa é responder corretamente a uma pergunta médica isolada e outra muito diferente é reproduzir o raciocínio clínico completo realizado por um profissional de saúde diante de um paciente real. Na prática clínica, o diagnóstico normalmente não surge de uma única resposta, mas de um processo progressivo: coleta-se informação, formulam-se hipóteses, solicitam-se exames, descartam-se possibilidades e decide-se um plano de manejo.
Até agora, muitas avaliações de inteligência artificial na medicina basearam-se em exames de múltipla escolha, como provas de licenciamento médico ou questões objetivas. Embora esses formatos sejam úteis para medir conhecimento, não capturam totalmente a complexidade do raciocínio clínico, especialmente quando há incerteza.
O estudo publicado na JAMA Network Open aborda justamente essa questão: os LLMs atuais conseguem raciocinar de forma confiável ao longo de todo o fluxo clínico?
Inscreva-se
na nossa
Newsletter
Como foi realizada a pesquisa sobre os LLMs na medicina?
Os autores avaliaram o desempenho de 21 modelos de linguagem de última geração utilizando 29 vinhetas clínicas padronizadas provenientes do MSD Manual. Essas vinhetas simulam casos clínicos passo a passo, desde a apresentação inicial do paciente até o diagnóstico e o manejo.
Os modelos avaliados incluíram sistemas de diferentes famílias, como GPT, Claude, Gemini, DeepSeek e Grok. Entre eles estavam modelos recentes e otimizados para o raciocínio, como GPT-5, Claude 4.5 Opus, Gemini 3.0 Pro e Grok 4.
Cada modelo deveria responder a perguntas organizadas em cinco domínios do raciocínio clínico:
- Diagnóstico diferencial;
- exames diagnósticos;
- diagnóstico final;
- manejo ou tratamento;
- e perguntas clínicas adicionais.
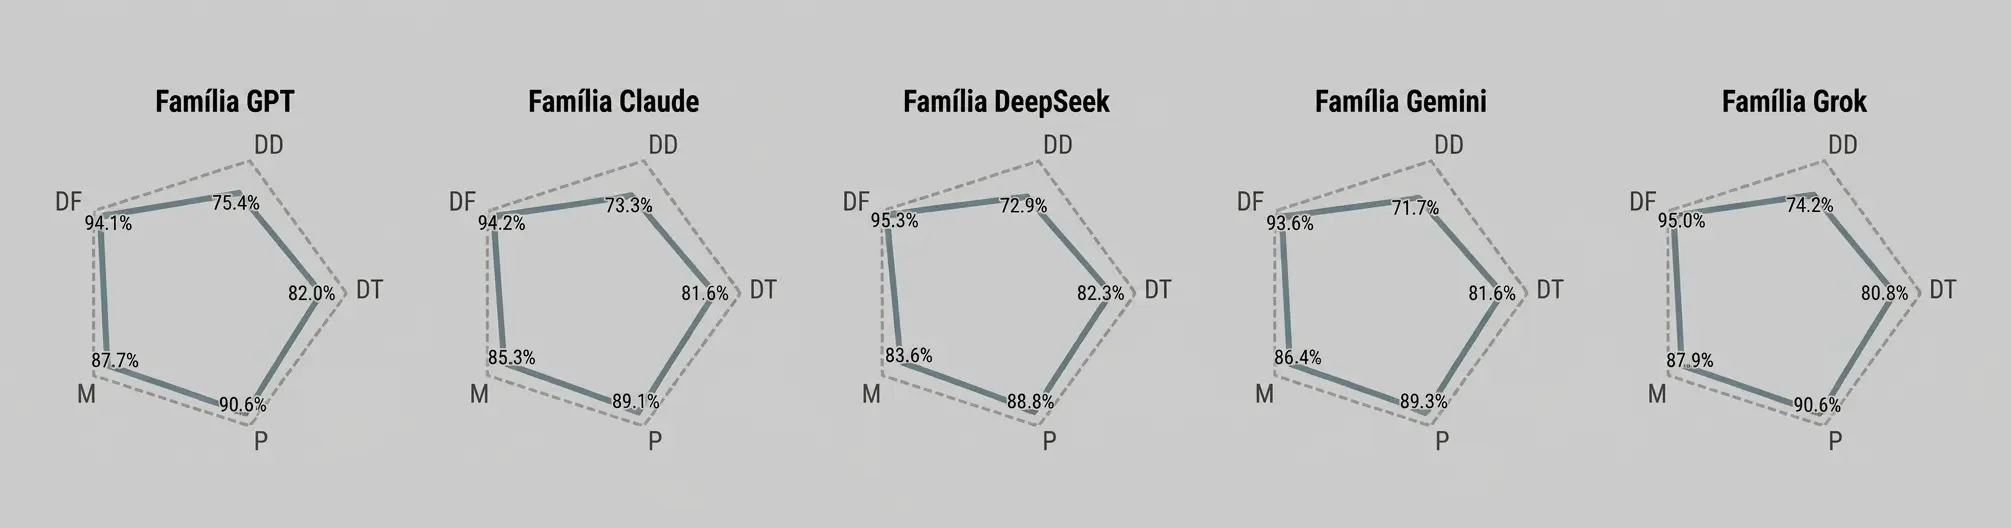
Para avaliar o desempenho, os pesquisadores não se limitaram a calcular a precisão global. Eles introduziram uma nova métrica chamada PrIME-LLM, que resume o desempenho equilibrado do modelo em cinco áreas do raciocínio clínico. Essa métrica é representada por gráficos de radar: quanto mais ampla e equilibrada for a área do gráfico, melhor será o desempenho do modelo ao longo de todo o processo clínico.
O que os principais resultados revelam sobre os LLMs nos diagnósticos?
Os resultados mostram um padrão muito claro: os LLMs atuais podem alcançar bons resultados quando solicitados a identificar o diagnóstico final, mas enfrentam muito mais dificuldades quando precisam gerar um diagnóstico diferencial.
Esse ponto é especialmente relevante, pois o diagnóstico diferencial é uma parte central do raciocínio médico. Ele consiste em considerar diferentes possibilidades diagnósticas, manter a incerteza e evitar concluir o caso cedo demais. Segundo os autores, os modelos tendem a convergir prematuramente para uma única resposta, em vez de raciocinar de maneira mais flexível, como faria um clínico.
Os modelos otimizados para o raciocínio obtiveram resultados melhores que os não otimizados, mas essa melhora não eliminou as principais limitações. Mesmo os modelos mais avançados continuaram apresentando falhas importantes nas primeiras etapas do raciocínio clínico.
Em conjunto, os melhores resultados no PrIME-LLM foram obtidos por modelos como Grok 4, GPT-5, GPT-4.5, Claude 4.5 Opus, Gemini 3.0 Flash e Gemini 3.0 Pro. No entanto, o estudo alerta que uma alta precisão global pode ocultar fragilidades importantes se o modelo não apresentar um desempenho equilibrado em todas as tarefas.
| Métrica ou resultado | Principal achado |
|---|---|
| Modelos avaliados | 21 LLMs |
| Casos clínicos utilizados | 29 vinhetas clínicas |
| Total de respostas analisadas | 16.254 |
| Melhor desempenho geral | Modelos recentes e otimizados para o raciocínio |
| Área mais forte | Diagnóstico final |
| Área mais fraca | Diagnóstico diferencial |
| Taxa de falha no diagnóstico diferencial | Superior a 0,80 em todos os modelos |
| Utilidade do PrIME-LLM | Detecta desequilíbrios que a precisão global pode ocultar |
| Conclusão clínica | Os LLMs não são seguros para uso autônomo sem supervisão |
Quais são as implicações para a prática clínica?
Este estudo apresenta um alerta importante: não basta que um modelo acerte os diagnósticos finais para que seja considerado seguro na medicina.
Na prática clínica, um dos maiores riscos é que uma ferramenta gere uma resposta aparentemente correta, mas sem considerar adequadamente outras possibilidades. Isso pode gerar uma falsa sensação de segurança, especialmente em contextos de alta incerteza.
Os resultados sugerem que os LLMs podem ser úteis em tarefas clínicas específicas, especialmente quando são bem delimitadas e supervisionadas por profissionais. Por exemplo, eles podem ajudar a resumir informações, estruturar dados, apoiar a revisão de documentação ou servir como ferramenta complementar em ambientes de baixa incerteza.
No entanto, os autores são claros: os modelos atuais não devem ser utilizados como agentes diagnósticos autônomos nem em contextos voltados ao paciente sem supervisão clínica. Seu desempenho ainda não reproduz a complexidade do raciocínio médico humano, especialmente nas etapas iniciais do diagnóstico.
Como esse avanço se relaciona com a NeuronUP?
Na NeuronUP trabalhamos com ferramentas digitais baseadas em evidências, voltadas à reabilitação e à estimulação cognitiva. Nesse contexto, estudos como este são especialmente relevantes porque ajudam a definir o papel realista da inteligência artificial na saúde.
A IA pode agregar valor quando integrada de forma responsável, transparente e supervisionada. Por exemplo, ela pode contribuir para:
- Apoiar a organização de informações clínicas e funcionais.
- Facilitar o acompanhamento estruturado dos pacientes.
- Ajudar a personalizar intervenções cognitivas com base em dados objetivos.
- Complementar, mas não substituir, o julgamento dos profissionais.
Este artigo reforça uma ideia fundamental: a tecnologia em saúde deve ser avaliada não apenas por sua capacidade de fornecer respostas corretas, mas também por sua segurança, confiabilidade e utilidade dentro do processo clínico completo.
No caso da neurorreabilitação, isso implica avançar rumo a modelos nos quais a inteligência artificial possa apoiar a tomada de decisões, mas sempre integrada a equipes profissionais e com critérios clínicos claros.
Conclusão
O estudo mostra que os modelos de linguagem avançaram significativamente e podem obter bons resultados em tarefas médicas específicas. No entanto, continuam apresentando limitações importantes no raciocínio clínico longitudinal, especialmente na geração de diagnósticos diferenciais e no manejo da incerteza.
A nova métrica PrIME-LLM permite avaliar esses modelos de forma mais completa do que a precisão global, pois identifica desequilíbrios entre diferentes etapas do processo clínico.
Em suma, os LLMs podem ser ferramentas promissoras para apoiar determinados processos de saúde, mas ainda não estão preparados para substituir o raciocínio clínico humano nem para tomar decisões diagnósticas de forma autônoma.
Bibliografia
- Rao AS, Esmail KP, Lee RS, Jiang S, Arraiza Carlo B, Gill J, Khanna P, Kalmowitz E, Montagnese B, Heydari K, Jiao Q, Bott E, Nguyen D, Wang G, Hood M, Landman AB, Succi MD. Large Language Model Performance and Clinical Reasoning Tasks. JAMA Network Open. 2026;9(4):e264003. doi:10.1001/jamanetworkopen.2026.4003.
Perguntas frequentes sobre os LLMs na medicina
1. Os modelos de linguagem (LLM) podem realizar diagnósticos clínicos de forma autônoma?
Não. Os modelos avaliados apresentam uma taxa de falha superior a 80% na geração de diagnósticos diferenciais e mostram tendência a convergir prematuramente para uma única opção. Por isso, não são seguros para operar de forma autônoma sem a supervisão direta de um profissional de saúde.
2. O que é a métrica PrIME-LLM e por que ela é importante?
É uma métrica desenvolvida para avaliar o desempenho equilibrado dos modelos em cinco domínios do processo clínico: diagnóstico diferencial, exames, diagnóstico final, tratamento e perguntas adicionais. Sua importância está em detectar fragilidades e desequilíbrios no raciocínio que as métricas tradicionais de precisão global costumam ocultar.
3. Quais são as principais limitações da inteligência artificial no fluxo clínico?
Embora as famílias de modelos avançados, como GPT, Claude, Gemini, Grok e DeepSeek, se destaquem ao identificar o diagnóstico final, elas sofrem uma queda acentuada nas etapas iniciais. Sua maior limitação é a incapacidade de administrar a incerteza diagnóstica e considerar diferentes hipóteses antes de concluir um caso.
4. Quais são as implicações dessas descobertas para a avaliação e a reabilitação cognitiva?
O estudo demonstra que a IA não deve substituir o julgamento profissional na avaliação neuropsicológica. No entanto, a tecnologia continua sendo um excelente recurso complementar para organizar informações clínicas, personalizar intervenções cognitivas e otimizar a documentação do paciente sob a orientação do especialista.

 Guia para profissionais: como abordar a dislexia em crianças com TDAH a partir da neuropsicologia baseada em evidências


Deixe um comentário