
Une montre connectée peut-elle anticiper les risques pour la santé ? Marta Arbizu Gómez, doctorante, présente comment le modèle d’intelligence artificielle SensorFM utilise les données des objets connectés pour analyser les profils physiologiques et leur impact sur l’évaluation clinique et neuropsychologique.
L’intégration de l’intelligence artificielle et des dispositifs connectés transforme la collecte continue de données de santé. Cet article analyse le potentiel clinique de SensorFM, un nouveau modèle fondationnel qui transforme l’enregistrement de biomarqueurs numériques en informations pertinentes pour la neuroréadaptation et l’évaluation cognitive. Découvrez comment la surveillance physiologique passive de variables telles que le sommeil, l’activité ou l’état émotionnel peut compléter l’intervention traditionnelle et ouvrir de nouvelles perspectives pour un suivi clinique personnalisé.
Quelles informations peut-on extraire d’un dispositif connecté ?
Les montres et bracelets connectés enregistrent en continu des informations sur notre activité physique et notre fonctionnement physiologique. Tout au long de la journée, ils peuvent mesurer les mouvements, la fréquence cardiaque, la variabilité de la fréquence cardiaque, la saturation en oxygène, la température cutanée, l’activité électrodermale ou les différentes phases du sommeil.
Cependant, transformer ces signaux en informations utiles sur le plan clinique demeure un défi. Les mesures obtenues peuvent varier d’une personne à l’autre, selon les dispositifs et les moments de la journée. En outre, les données présentent souvent des interruptions lorsque l’utilisateur retire sa montre, que la batterie est déchargée ou qu’un capteur cesse de fonctionner correctement.
Par ailleurs, développer un algorithme différent pour chaque problème de santé nécessite de grandes quantités de données correctement étiquetées, ce qui est particulièrement difficile et coûteux dans le domaine de la santé.
Pour surmonter ces limites, une équipe de Google Research et d’autres institutions a développé SensorFM, un modèle fondationnel d’intelligence artificielle entraîné à apprendre des représentations générales de la santé à partir de données issues de dispositifs connectés. L’étude, publiée sous forme de prépublication, examine si un seul modèle peut exploiter ces signaux pour effectuer des prédictions dans différents domaines de la santé.
Qu’est-ce qu’un modèle fondationnel appliqué aux données de santé ?
Les modèles fondationnels sont entraînés sur des quantités massives d’informations, généralement sans qu’une étiquette spécifique soit associée à chaque donnée. Au cours de ce processus, le modèle apprend des schémas généraux qui peuvent ensuite être adaptés à de multiples tâches.
SensorFM suit cette approche, mais au lieu d’apprendre à partir de textes ou d’images, il utilise des séries temporelles enregistrées par des capteurs.
Le modèle a été préentraîné à partir de :
- Plus de un milliard de minutes de données.
- Des informations provenant de cinq millions de personnes.
- Des participants issus de plus de 100 pays.
- Plus de 20 modèles d’appareils Fitbit et Pixel Watch.
- Cinq grands types de capteurs : photopléthysmographie, accéléromètre, température cutanée, activité électrodermale et altimètre.
À partir de ces capteurs, les chercheurs ont obtenu 34 variables enregistrées chaque minute, notamment la fréquence cardiaque, différentes mesures de la variabilité cardiaque, la saturation en oxygène, le nombre de pas, la température cutanée et les phases du sommeil.
Le modèle analysait des fenêtres complètes de 24 heures et apprenait à reconstruire des parties des informations artificiellement masquées. Ainsi, il apprenait non seulement les valeurs individuelles de chaque signal, mais aussi leurs relations et leur évolution au cours de la journée.
Abonnez-vous
à notre
Newsletter
Qu’est-ce que les chercheurs cherchaient à découvrir ?
L’étude s’est concentrée sur trois questions principales :
- Tout d’abord, les auteurs voulaient vérifier si l’augmentation simultanée de la quantité de données et de la taille du modèle entraînait des améliorations prévisibles de ses performances.
- Ensuite, ils ont évalué si les représentations apprises pouvaient être réutilisées pour prédire différents aspects de la santé, même lorsque peu d’échantillons étiquetés étaient disponibles.
- Enfin, ils ont examiné si les prédictions de SensorFM pouvaient être intégrées à un assistant personnel de santé fondé sur l’intelligence artificielle afin de générer des réponses plus pertinentes, personnalisées et sûres.
Pour évaluer le modèle, ils ont utilisé des informations indépendantes provenant de 13 985 participants, issues de trois études prospectives portant sur la santé métabolique et cardiovasculaire, la santé mentale et le sommeil.
Un même modèle pour 35 tâches liées à la santé
SensorFM a été évalué sur 35 tâches différentes, réparties en six grands domaines :
- Santé cardiovasculaire.
- Santé métabolique.
- Santé mentale.
- Sommeil.
- Mode de vie.
- Caractéristiques démographiques et physiologiques.
Parmi les variables analysées figuraient le risque cardiovasculaire, l’hypertension, le diabète, la résistance à l’insuline, les taux d’hémoglobine glyquée et de triglycérides, la dépression, l’anxiété, le stress perçu et les troubles du sommeil.
Le modèle a également été utilisé pour estimer des caractéristiques telles que l’âge, l’indice de masse corporelle, la taille et le poids. Ces variables ne doivent pas nécessairement être considérées comme des objectifs cliniques en soi, mais plutôt comme un moyen de vérifier la quantité d’informations physiologiques et comportementales apprises par le système.
Quels ont été les principaux résultats ?
Les résultats montrent que le modèle a appris une représentation généralisable de la physiologie et du comportement enregistrés par les dispositifs connectés.
SensorFM a surpassé les modèles supervisés traditionnels fondés sur des variables conçues manuellement pour 34 des 35 tâches évaluées. Autrement dit, les représentations apprises directement à partir de grandes quantités de données se sont révélées plus informatives que les résumés conventionnels calculés à partir des mêmes signaux.
En outre, les performances se sont améliorées à mesure que le nombre de participants utilisés pendant l’entraînement et la capacité du modèle augmentaient conjointement. La version la plus volumineuse a obtenu les meilleurs résultats pour 33 des 35 tâches.
Les auteurs ont également constaté que les modèles de plus grande taille dépendaient moins des informations démographiques ajoutées ultérieurement. Cela suggère qu’une partie des différences physiologiques associées à des variables telles que l’âge ou l’indice de masse corporelle était déjà représentée dans les schémas enregistrés par les capteurs.
Apprendre avec moins de données cliniques étiquetées
L’un des résultats les plus importants concernait la capacité du modèle à s’adapter à de nouvelles tâches à partir d’un nombre relativement faible de données étiquetées.
Dans la recherche en santé, recueillir des informations en continu au moyen d’une montre connectée est relativement simple, tandis qu’obtenir des diagnostics confirmés, des analyses sanguines ou des questionnaires cliniques complets est beaucoup plus coûteux.
Ayant préalablement appris des schémas généraux à partir de millions de participants, SensorFM avait besoin de moins d’exemples étiquetés pour développer de nouveaux modèles prédictifs. Cette efficacité pourrait faciliter l’étude de problèmes de santé pour lesquels les cohortes cliniques sont de petite taille ou les informations limitées.
Néanmoins, la précision continuait d’augmenter avec la disponibilité de davantage de données étiquetées. Le modèle ne dispense donc pas de disposer d’échantillons cliniques représentatifs et correctement caractérisés.
Peut-il reconstruire les données manquantes ?
Les données des dispositifs connectés sont souvent incomplètes. L’utilisateur peut retirer sa montre pendant une partie de la journée, un capteur peut se déconnecter ou les signaux peuvent comporter des erreurs.
SensorFM a été spécifiquement entraîné pour composer avec ces données manquantes. Lors des tests, il a surpassé les méthodes de référence dans différentes tâches de reconstruction :
- 74,8 % pour l’imputation de données supprimées aléatoirement.
- 38,8 % pour la reconstruction d’intervalles temporels intermédiaires.
- 39,6 % pour la prédiction d’intervalles situés à la fin de l’enregistrement.
- 83,7 % en cas d’absence de signaux complets provenant de certains capteurs.
Les chercheurs ont également simulé la perte d’une heure complète de données. Après avoir reconstruit cet intervalle, le modèle a conservé une précision de 99,7 % pour estimer le nombre quotidien de pas, de 99,9 % pour la durée de sommeil profond et de 99,2 % pour les minutes d’activité physique légère.
Cette capacité pourrait éviter qu’une interruption ponctuelle fausse les récapitulatifs quotidiens présentés à l’utilisateur.
Des agents d’intelligence artificielle pour adapter le modèle
Bien que les représentations apprises par SensorFM puissent être utilisées avec des modèles statistiques relativement simples, les chercheurs ont également exploré une stratégie automatisée visant à améliorer son adaptation à chaque tâche.
Ils ont ainsi créé une sorte de « classe » composée de plusieurs agents fondés sur des modèles de langage. Ces agents généraient du code, entraînaient différentes solutions, comparaient les résultats et modifiaient progressivement leurs propositions.
Au total, le système a réalisé plus de 30 000 expériences automatisées.
Les solutions trouvées par les agents ont amélioré les performances par rapport aux modèles linéaires pour 16 des 20 tâches de classification et 12 des 15 tâches de régression.
Ce résultat laisse entrevoir une automatisation partielle du processus de développement des modèles prédictifs. Toutefois, les solutions générées doivent continuer à faire l’objet d’un examen et d’une validation rigoureux, en particulier lorsqu’elles sont appliquées à des données de santé.
Des données de la montre à un assistant personnel de santé
Les chercheurs ont ensuite intégré les prédictions de SensorFM à un assistant personnel de santé fondé sur un modèle de langage.
L’objectif était de vérifier si l’assistant pouvait mieux répondre aux questions de santé lorsqu’il disposait, en plus des données démographiques et des récapitulatifs quotidiens du dispositif connecté, des estimations générées par SensorFM.
31 profils réels ont été utilisés et des réponses ont été générées selon trois conditions :
- Données démographiques et mesures quotidiennes du dispositif connecté.
- Données démographiques, mesures quotidiennes et prédictions de SensorFM.
- Données démographiques, mesures quotidiennes et valeurs cliniques réelles.
L’image 1 récapitule le fonctionnement du système et le protocole d’évaluation. SensorFM transforme les données enregistrées par le dispositif connecté en prédictions de santé, qui sont ajoutées au contexte de l’assistant avant la génération d’une réponse personnalisée.
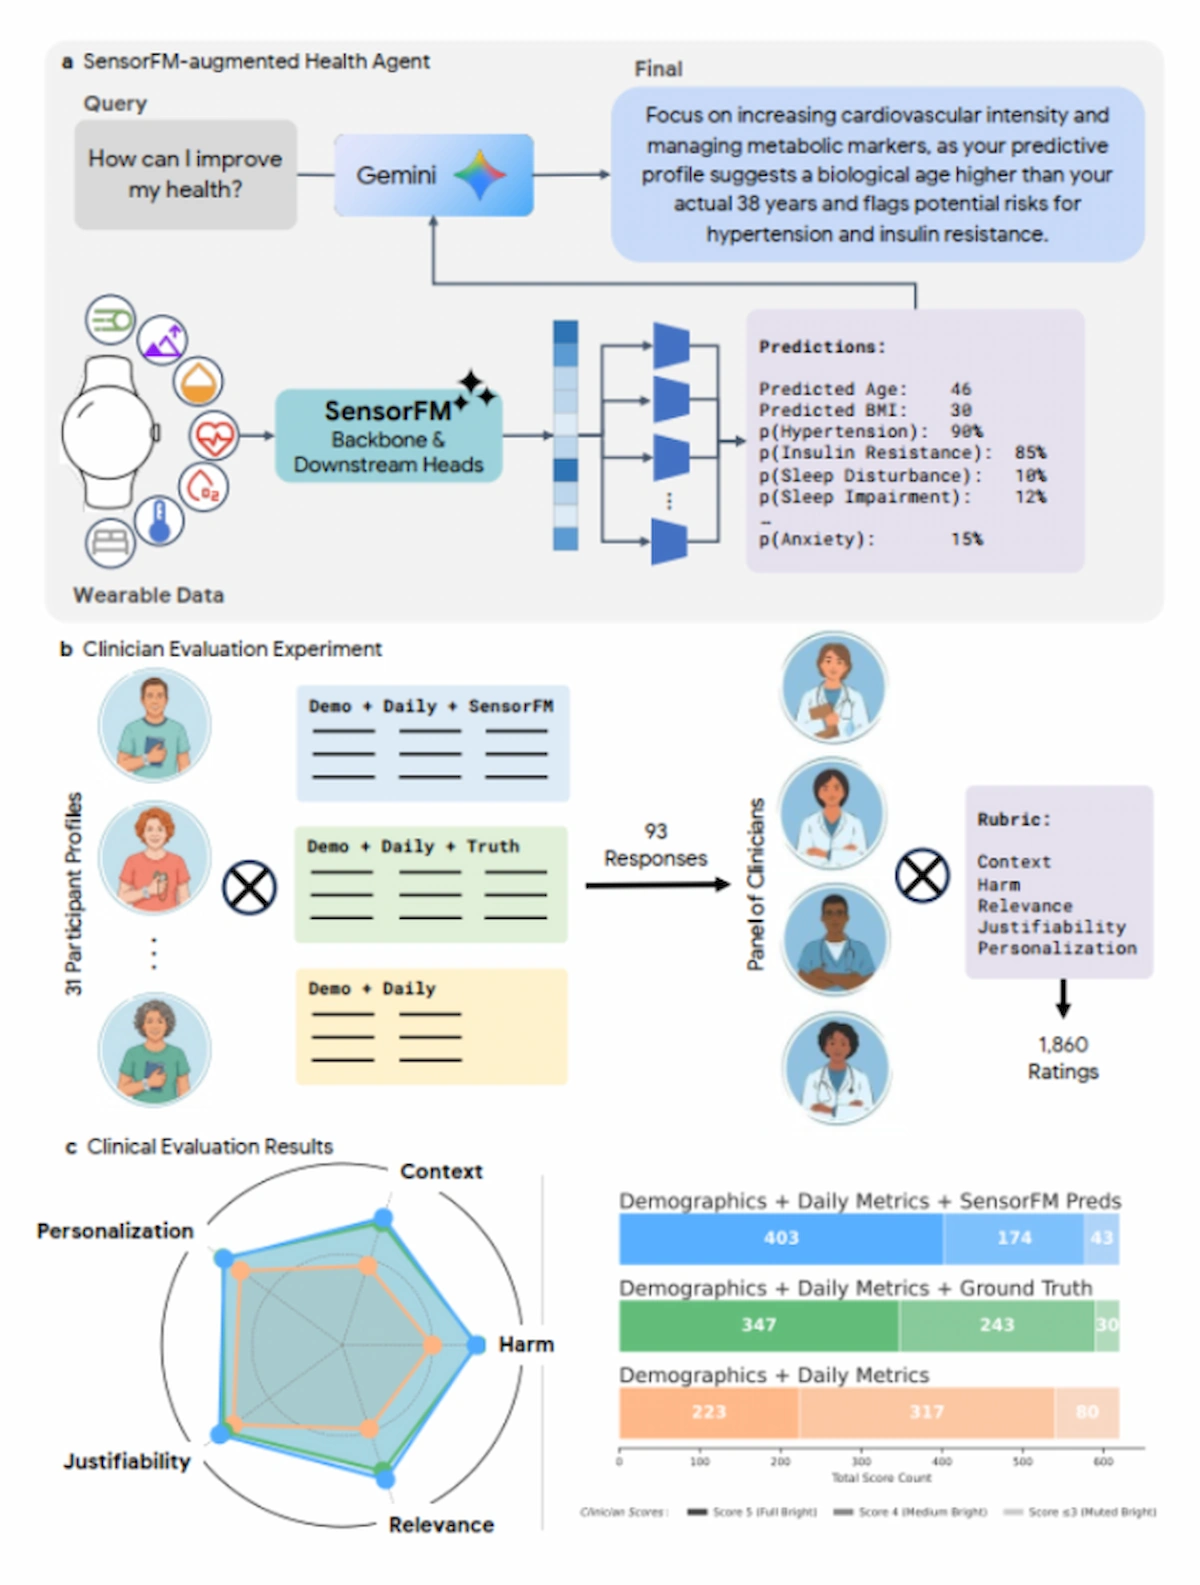
Quatre professionnels de santé ont évalué les réponses selon leur contextualisation, leur pertinence, leur personnalisation, leur justification et leur risque potentiel. Au total, 1 860 évaluations cliniques ont été recueillies.
Les réponses intégrant les prédictions de SensorFM étaient significativement meilleures que celles fondées uniquement sur les récapitulatifs quotidiens. En outre, aucune différence statistiquement significative n’a été observée entre les réponses générées à partir des prédictions du modèle et celles utilisant les valeurs cliniques réelles.
Ce résultat ne signifie pas que SensorFM peut remplacer une évaluation médicale. Il indique que ses prédictions ont fourni à l’assistant un contexte supplémentaire utile pour générer des réponses plus spécifiques et cohérentes.
Quelles sont les limites de l’étude ?
Malgré l’ampleur des données utilisées, les résultats doivent être interprétés avec prudence.
Tout d’abord, il s’agit d’une prépublication, qui n’a donc pas encore suivi l’ensemble du processus conventionnel d’évaluation par les pairs.
Le modèle a été entraîné principalement à partir de dispositifs Fitbit et Pixel Watch. Rien ne garantit qu’il fonctionne de la même manière avec ceux d’autres fabricants, dont les capteurs et les méthodes de traitement peuvent différer.
Par ailleurs, les chercheurs ont utilisé des variables agrégées à la minute, et non les signaux physiologiques d’origine. Cette approche permet d’analyser de longues périodes, mais peut éliminer des informations à haute fréquence utiles à certaines applications cliniques.
Une partie des résultats utilisés pour évaluer le modèle provenait de diagnostics autodéclarés, de traitements médicamenteux ou de questionnaires de dépistage, et non toujours de diagnostics cliniques confirmés. La population étudiée différait également de la population générale, avec une plus forte représentation des femmes et des utilisateurs de dispositifs connectés.
Enfin, l’évaluation de l’assistant personnel de santé s’est limitée à des réponses statiques et à un seul tour de conversation. Une interaction clinique réelle nécessiterait des questions supplémentaires, une analyse du contexte et un suivi longitudinal.
Quelles pourraient être les implications pour la santé numérique ?
Cette étude marque une transition entre des algorithmes conçus pour une tâche unique et des modèles généraux capables de réutiliser une même représentation pour différents problèmes de santé.
Les dispositifs connectés offrent une vision longitudinale du fonctionnement au quotidien, contrairement aux mesures ponctuelles réalisées lors d’une consultation. Associés à des modèles correctement validés, ils pourraient aider à détecter des changements physiologiques ou comportementaux, à repérer les personnes nécessitant une évaluation plus approfondie et à assurer un suivi plus continu.
En neurologie et en neuropsychologie, ce type de technologie pourrait être particulièrement intéressant pour étudier les changements touchant le sommeil, l’activité, les habitudes quotidiennes, la réponse autonome ou l’état émotionnel. Ces changements peuvent accompagner différentes maladies neurologiques et psychiatriques, mais les prédictions obtenues au moyen de dispositifs connectés ne doivent pas être considérées comme des diagnostics.
Comment NeuronUP peut-elle contribuer ?
Les informations passivement recueillies au moyen de dispositifs connectés peuvent être complétées par des évaluations cognitives et des programmes d’intervention structurés.
Des plateformes comme NeuronUP permettent d’évaluer et de travailler des domaines tels que l’attention, la mémoire, les fonctions exécutives, le langage ou la cognition sociale. À l’avenir, l’association de mesures cognitives à des données longitudinales sur le sommeil, l’activité et la physiologie pourrait offrir une vision plus complète de l’évolution de chaque personne.
Cette intégration pourrait faciliter la personnalisation des interventions, la détection des changements fonctionnels et le suivi de la réponse au traitement. Des études cliniques spécifiques, des modèles interprétables et des protocoles garantissant la confidentialité, l’équité et la sécurité des utilisateurs seront nécessaires à cette fin.
Conclusion
SensorFM montre qu’un entraînement à grande échelle sur des données non étiquetées issues de dispositifs connectés peut générer des représentations utiles dans de nombreux domaines de la santé.
Le modèle a surpassé les méthodes traditionnelles dans la plupart des tâches analysées, a pu reconstruire les données manquantes et a apporté des informations supplémentaires à un assistant personnel de santé. Ses prédictions doivent toutefois être considérées comme des outils potentiels de dépistage, de stratification du risque et de suivi, et non comme des substituts au diagnostic clinique.
Ces résultats représentent une étape vers des systèmes capables de transformer de grandes quantités de données du quotidien en informations personnalisées. Le défi consiste désormais à démontrer que ces outils conservent leur précision, leur sécurité et leur utilité lorsqu’ils sont appliqués à des populations cliniques diverses et dans des contextes de soins réels.
Bibliographie
- Narayanswamy G, Xu MA, Heydari AA, et al. Towards a General Intelligence and Interface for Wearable Health Data. arXiv. 2026. https://doi.org/10.48550/arXiv.2605.22759
Questions fréquentes sur l’IA et les dispositifs connectés en neuroréadaptation
1. Qu’est-ce que le modèle SensorFM et comment est-il utilisé en santé numérique ?
SensorFM est un modèle fondationnel d’intelligence artificielle développé par Google Research et d’autres institutions, entraîné sur plus d’un milliard de minutes de données issues de dispositifs connectés. Il apprend des schémas généraux à partir de biosignaux afin d’effectuer des prédictions applicables à de nombreuses tâches de santé, de la qualité du sommeil aux indicateurs de santé métabolique et mentale.
2. Quels avantages les biomarqueurs numériques apportent-ils à la neuroréadaptation ?
Les montres et bracelets connectés offrent une vision longitudinale et continue du fonctionnement quotidien de l’utilisateur, en enregistrant des mesures telles que la variabilité de la fréquence cardiaque, les phases du sommeil ou l’activité physique. Cette surveillance passive complète les évaluations ponctuelles en consultation et permet aux neuropsychologues de repérer de subtils changements dans les habitudes, la réponse autonome ou l’état émotionnel associés à diverses pathologies.
3. Comment l’intelligence artificielle compense-t-elle la perte de données des montres connectées ?
Les données des dispositifs connectés sont souvent interrompues en raison d’une panne de batterie ou parce que l’utilisateur retire l’appareil. Des modèles comme SensorFM sont entraînés à reconstruire ces informations manquantes ; lors de simulations où une heure complète d’enregistrement faisait défaut, le système a conservé une précision supérieure à 99 % pour estimer le sommeil profond et le nombre de pas quotidiens.
4. Les prédictions des dispositifs connectés peuvent-elles remplacer le diagnostic clinique ?
Non. Les variables estimées par les modèles fondationnels à partir de dispositifs connectés ne constituent pas, à elles seules, des objectifs ou des diagnostics cliniques. Ce sont des outils de dépistage et de suivi qui apportent un contexte supplémentaire utile à la personnalisation des interventions, mais ils doivent toujours être associés à des évaluations cliniques structurées et à la supervision d’un professionnel de santé.

 Formation de la fovéa et vision : mécanismes et implications dans la dégénérescence maculaire liée à l’âge (DMLA)

Laisser un commentaire