
تحلل الباحثة في مرحلة الدكتوراه Marta Arbizu Gómez الأدلة العلمية الحالية حول حدود نماذج اللغة في الاستدلال السريري وتأثيرها في الممارسة السريرية اليومية.
تكشف دراسة منشورة في JAMA Network Open أن نماذج اللغة (LLM) تتجاوز نسبة خطئها 80% في التشخيص التفريقي، رغم دقتها النهائية. وفي التقييم العصبي النفسي وإعادة التأهيل العصبي، توضح هذه البيانات أن الذكاء الاصطناعي لا يحل محل الاستدلال السريري البشري، بل ينبغي استخدامه أداةً مساندة فقط تحت إشراف مهني.
لماذا من المهم تقييم الاستدلال السريري للذكاء الاصطناعي؟
تحظى نماذج اللغة الكبيرة، المعروفة باسم LLMs، بدور متزايد الأهمية في المجال الصحي. ويجري استخدامها أو استكشاف استخدامها لتلخيص السجلات الطبية، ودعم اتخاذ القرارات، والإجابة عن الأسئلة الطبية، وإنشاء التقارير، أو المساعدة في مهام توثيق الرعاية السريرية.
لكن الإجابة الصحيحة عن سؤال طبي منفرد تختلف تماماً عن إعادة إنتاج الاستدلال السريري الكامل الذي يجريه اختصاصي صحي أمام مريض حقيقي. ففي الممارسة السريرية، لا ينشأ التشخيص عادةً من إجابة واحدة، بل من عملية تدريجية: تُجمع المعلومات، وتُطرح الفرضيات، وتُطلب الفحوص، وتُستبعد الاحتمالات، وتُحدَّد خطة التدبير.
حتى الآن، استندت كثير من تقييمات الذكاء الاصطناعي في الطب إلى اختبارات متعددة الخيارات، مثل اختبارات الترخيص الطبي أو أسئلة الاختيار من متعدد. ورغم فائدة هذه الصيغ في قياس المعرفة، فإنها لا تلتقط تماماً تعقيد الاستدلال السريري، ولا سيما عند وجود عدم يقين.
وتتناول الدراسة المنشورة في JAMA Network Open هذه المسألة تحديداً: هل تستطيع نماذج LLM الحالية الاستدلال بصورة موثوقة عبر مسار الرعاية السريرية بأكمله؟
كيف أُجري البحث حول نماذج LLM في الطب؟
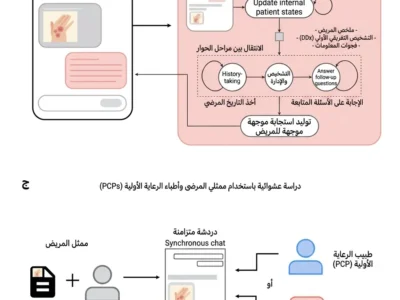
قيّم المؤلفون أداء 21 نموذجاً لغوياً من أحدث جيل باستخدام 29 حالة سريرية معيارية مأخوذة من دليل MSD. وتحاكي هذه الحالات حالات سريرية خطوةً خطوة، بدءاً من عرض المريض الأولي وصولاً إلى التشخيص والتدبير.
شملت النماذج التي جرى تقييمها أنظمةً من عائلات مختلفة، مثل GPT وClaude وGemini وDeepSeek وGrok. وكان من بينها نماذج حديثة ومحسّنة للاستدلال، مثل GPT-5 وClaude 4.5 Opus وGemini 3.0 Pro وGrok 4.
وكان على كل نموذج الإجابة عن أسئلة منظمة ضمن خمسة مجالات من الاستدلال السريري:
- التشخيص التفريقي؛
- الفحوص التشخيصية؛
- التشخيص النهائي؛
- التدبير أو العلاج؛
- والأسئلة السريرية الإضافية.
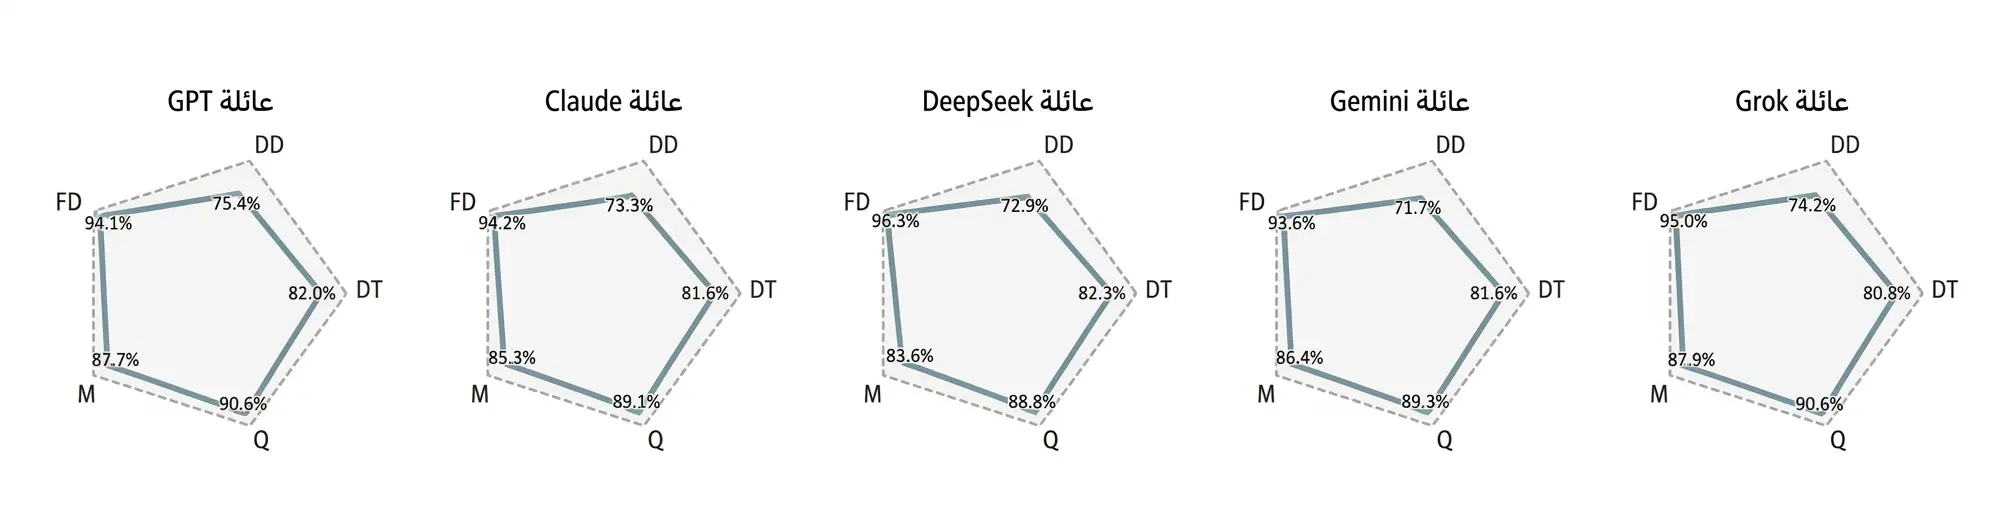
ولتقييم الأداء، لم يقتصر الباحثون على حساب الدقة الإجمالية، بل قدموا مقياساً جديداً أُطلق عليه اسم PrIME-LLM، يلخص الأداء المتوازن للنموذج في خمسة مجالات من الاستدلال السريري. ويُمثَّل هذا المقياس من خلال مخططات رادارية: فكلما كانت مساحة المخطط أوسع وأكثر توازناً، كان أداء النموذج أفضل عبر العملية السريرية بأكملها.
ماذا تكشف النتائج الرئيسية عن نماذج LLM في التشخيص؟
تظهر النتائج نمطاً واضحاً للغاية: تستطيع نماذج LLM الحالية تحقيق نتائج جيدة عندما يُطلب منها تحديد التشخيص النهائي، لكنها تواجه صعوبات أكبر بكثير عندما يتعين عليها إعداد تشخيص تفريقي.
وتكتسب هذه النقطة أهمية خاصة، لأن التشخيص التفريقي جزء محوري من الاستدلال الطبي. فهو يتضمن النظر في احتمالات تشخيصية مختلفة، والحفاظ على عدم اليقين، وتجنب حسم الحالة في وقت مبكر جداً. ووفقاً للمؤلفين، تميل النماذج إلى التقارب المبكر نحو إجابة واحدة، بدلاً من الاستدلال بمرونة أكبر كما يفعل الاختصاصي السريري.
حققت النماذج المحسّنة للاستدلال نتائج أفضل من النماذج غير المحسّنة، لكن هذا التحسن لم يزل القيود الرئيسية. وحتى أكثر النماذج تقدماً واصلت إظهار إخفاقات مهمة في المراحل الأولى من الاستدلال السريري.
وبوجه عام، حققت نماذج مثل Grok 4 وGPT-5 وGPT-4.5 وClaude 4.5 Opus وGemini 3.0 Flash وGemini 3.0 Pro أفضل النتائج في مقياس PrIME-LLM. غير أن الدراسة تحذر من أن الدقة الإجمالية المرتفعة قد تخفي نقاط ضعف مهمة إذا لم يؤدِّ النموذج بصورة متوازنة في جميع المهام.
| المقياس أو النتيجة | الاستنتاج الرئيسي |
|---|---|
| النماذج التي جرى تقييمها | 21 نموذجاً من LLM |
| الحالات السريرية المستخدمة | 29 حالة سريرية |
| إجمالي الإجابات التي جرى تحليلها | 16.254 |
| أفضل أداء عام | نماذج حديثة ومحسّنة للاستدلال |
| أقوى مجال | التشخيص النهائي |
| أضعف مجال | التشخيص التفريقي |
| معدل الإخفاق في التشخيص التفريقي | أعلى من 0,80 في جميع النماذج |
| فائدة PrIME-LLM | يكشف الاختلالات التي قد تخفيها الدقة الإجمالية |
| الاستنتاج السريري | نماذج LLM غير آمنة للاستخدام المستقل دون إشراف |
ما التداعيات على الممارسة السريرية؟
تطرح هذه الدراسة تحذيراً مهماً: لا يكفي أن يصيب النموذج التشخيصات النهائية حتى نعدّه آمناً في الطب.
في الممارسة السريرية، يتمثل أحد أكبر المخاطر في أن تنتج أداة إجابة تبدو صحيحة، من دون أن تكون قد أخذت الاحتمالات الأخرى في الاعتبار على نحو ملائم. وقد يؤدي ذلك إلى شعور زائف بالأمان، ولا سيما في سياقات عدم اليقين المرتفع.
وتشير النتائج إلى أن نماذج LLM قد تكون مفيدة في مهام سريرية محددة، ولا سيما عندما تكون محددة بوضوح وتحت إشراف المختصين. فعلى سبيل المثال، قد تساعد في تلخيص المعلومات، وتنظيم البيانات، ودعم مراجعة الوثائق، أو العمل أداةً مساندة في البيئات ذات عدم اليقين المنخفض.
لكن المؤلفين واضحون: لا ينبغي استخدام النماذج الحالية بوصفها وكلاء تشخيص مستقلين ولا في السياقات الموجهة إلى المرضى من دون إشراف سريري. فما زال أداؤها لا يحاكي تعقيد الاستدلال الطبي البشري، وخصوصاً في المراحل الأولى من التشخيص.
كيف يرتبط هذا التقدم بـ NeuronUP؟
نعمل في NeuronUP على أدوات رقمية موجهة إلى إعادة التأهيل والتحفيز المعرفي وقائمة على الأدلة. وفي هذا السياق، تكتسب دراسات كهذه أهمية خاصة لأنها تساعد على تحديد الدور الواقعي للذكاء الاصطناعي في الصحة.
يمكن للذكاء الاصطناعي أن يضيف قيمة عندما يُدمج بصورة مسؤولة وشفافة وتحت الإشراف. فعلى سبيل المثال، يمكنه المساهمة في:
- دعم تنظيم المعلومات السريرية والوظيفية.
- تيسير المتابعة المنظمة للمرضى.
- المساعدة في تخصيص التدخلات المعرفية استناداً إلى بيانات موضوعية.
- استكمال حكم المختصين، لا استبداله.
يعزز هذا المقال فكرة أساسية: ينبغي تقييم التكنولوجيا الصحية ليس فقط وفق قدرتها على تقديم إجابات صحيحة، بل أيضاً وفق سلامتها وموثوقيتها وفائدتها ضمن العملية السريرية الكاملة.
وفي حالة إعادة التأهيل العصبي، يعني ذلك التقدم نحو نماذج يمكن للذكاء الاصطناعي فيها دعم اتخاذ القرارات، ولكن مع دمجه دائماً في فرق مهنية وبالاستناد إلى معايير سريرية واضحة.
الخلاصة
توضح الدراسة أن نماذج اللغة حققت تقدماً ملحوظاً ويمكنها تقديم نتائج جيدة في مهام طبية محددة. ومع ذلك، لا تزال تعاني قيوداً مهمة في الاستدلال السريري الطولي، ولا سيما في إنشاء التشخيصات التفريقية والتعامل مع عدم اليقين.
ويتيح المقياس الجديد PrIME-LLM تقييم هذه النماذج بصورة أشمل من الدقة الإجمالية، إذ يحدد الاختلالات بين المراحل المختلفة للعملية السريرية.
وخلاصة القول إن نماذج LLM قد تكون أدوات واعدة لدعم عمليات صحية معينة، لكنها ليست مستعدة بعد لتحل محل الاستدلال السريري البشري أو لاتخاذ قرارات تشخيصية بصورة مستقلة.
المراجع
- Rao AS, Esmail KP, Lee RS, Jiang S, Arraiza Carlo B, Gill J, Khanna P, Kalmowitz E, Montagnese B, Heydari K, Jiao Q, Bott E, Nguyen D, Wang G, Hood M, Landman AB, Succi MD. Large Language Model Performance and Clinical Reasoning Tasks. JAMA Network Open. 2026;9(4):e264003. doi:10.1001/jamanetworkopen.2026.4003.
الأسئلة الشائعة حول نماذج LLM في الطب
1. هل تستطيع نماذج اللغة (LLM) إجراء تشخيصات سريرية بصورة مستقلة؟
لا. تُظهر النماذج التي جرى تقييمها معدل إخفاق يتجاوز 80% في إنشاء التشخيصات التفريقية، وتميل إلى التقارب المبكر نحو خيار واحد. ولذلك فهي غير آمنة للعمل بصورة مستقلة من دون إشراف مباشر من اختصاصي صحي.
2. ما مقياس PrIME-LLM ولماذا هو مهم؟
هو مقياس صُمم لتقييم الأداء المتوازن للنماذج في خمسة مجالات من العملية السريرية: التشخيص التفريقي، والفحوص، والتشخيص النهائي، والعلاج، والأسئلة الإضافية. وتكمن أهميته في أنه يكشف نقاط الضعف والاختلالات في الاستدلال التي غالباً ما تخفيها المقاييس التقليدية للدقة الإجمالية.
3. ما أبرز حدود الذكاء الاصطناعي في المسار السريري؟
رغم تفوق عائلات النماذج المتقدمة، مثل GPT وClaude وGemini وGrok وDeepSeek، في تحديد التشخيص النهائي، فإنها تتراجع بشدة في المراحل الأولى. ويتمثل أكبر حدودها في عدم القدرة على إدارة عدم اليقين التشخيصي والنظر في فرضيات مختلفة قبل حسم الحالة.
4. ما تداعيات هذه النتائج على التقييم وإعادة التأهيل المعرفي؟
تثبت الدراسة أن الذكاء الاصطناعي لا ينبغي أن يحل محل الحكم المهني في التقييم العصبي النفسي. ومع ذلك، تظل التكنولوجيا مورداً تكميلياً ممتازاً لتنظيم المعلومات السريرية، وتخصيص التدخلات المعرفية، وتحسين توثيق حالة المريض وفقاً لحكم الاختصاصي.

 دليل للمهنيين: كيفية التعامل مع عسر القراءة لدى الأطفال المصابين باضطراب فرط الحركة وتشتت الانتباه من منظور علم النفس العصبي القائم على الدليل


اترك تعليقاً